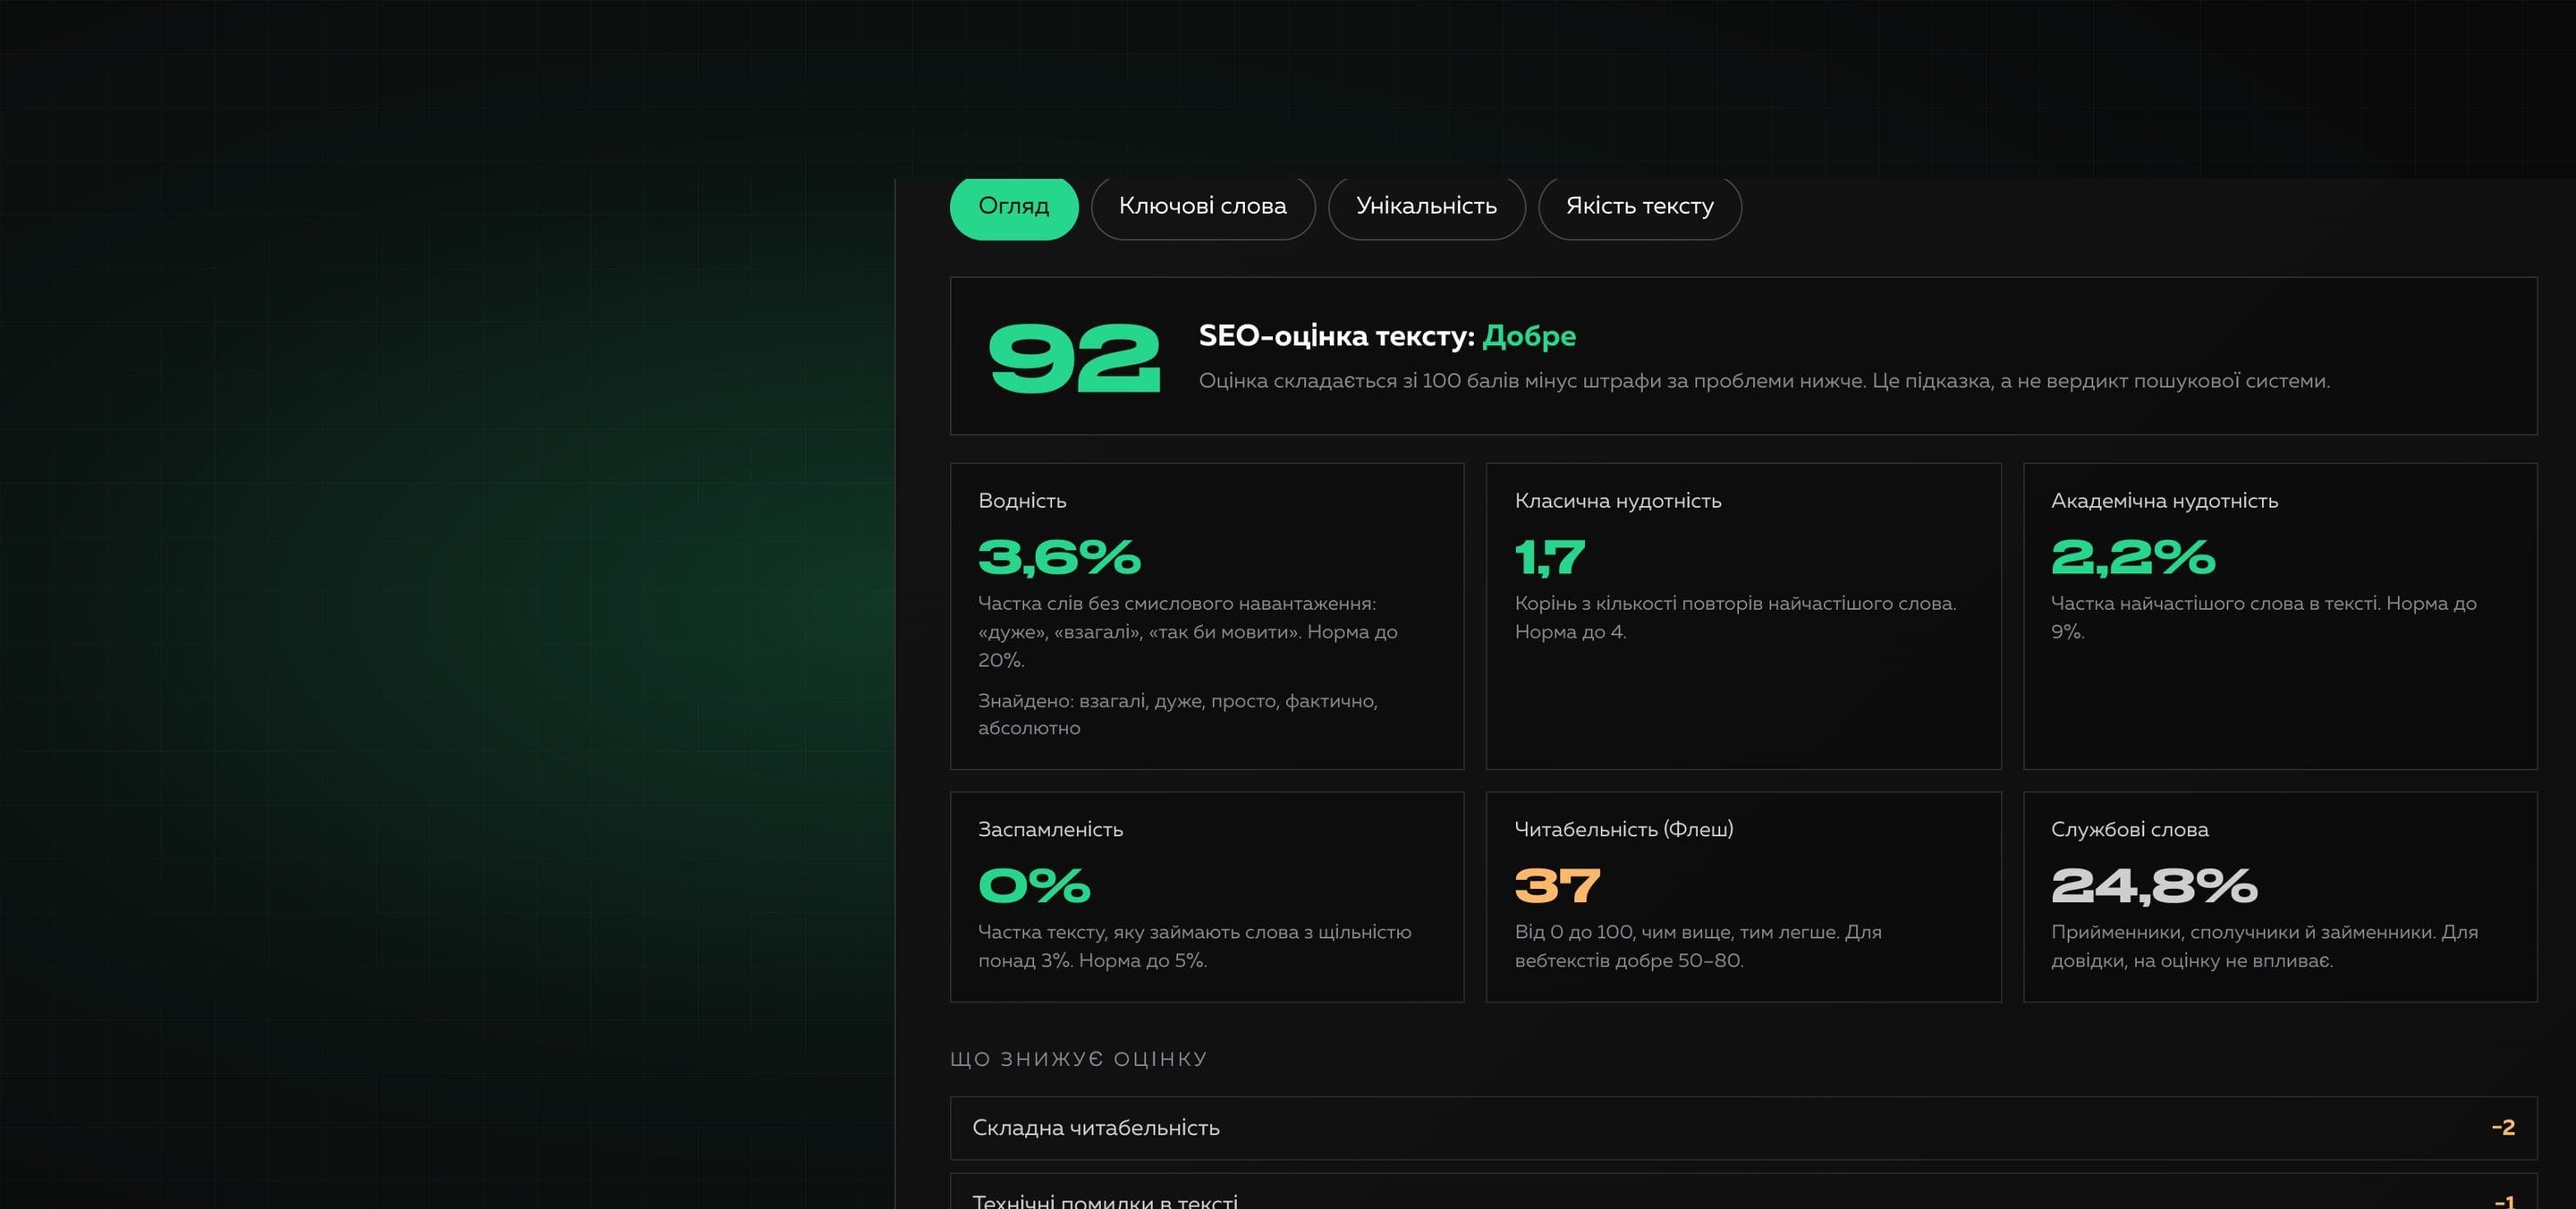
SEO-аналіз і унікальність тексту
SEO-аналіз і унікальність тексту — це власний продукт Creomatix для редакторів і SEO-фахівців. Інструмент рахує звичні за text.ru показники, порівнює текст з іншими текстами з підсвіткою збігів, шукає повтори й за наявності пошукового API перевіряє фрагменти в інтернеті. Основні перевірки виконуються у браузері, тому текст нікуди не надсилається. Спробувати його можна на сторінці «SEO-аналіз і унікальність тексту», а про те, що перевіряти перед публікацією, розповідаємо в блозі.
Що було зроблено?
Вихідним матеріалом був макет сервісу з кабінетом, і перша ж перевірка показала, що аналіз у ньому повністю імітований. Відсоток унікальності обчислювався з хешу тексту, а «джерела збігів» були вигадані: адреси на реальних сайтах (новинних, академічних, BBC) складались зі списку доменів і початку першого речення. Для двох тестових текстів («lorem ipsum» та конкретна автомобільна новина) відповіді були прописані прямо в коді. Водність, заспамленість, читабельність і SEO-оцінка теж брались із хешу: те саме число для того самого тексту, але жодного зв’язку зі змістом. Стоп-слова українською були записані латиницею («na», «shcho»), тому не працювали взагалі. Крім того, поділ на речення ламався на скороченнях і десяткових, файли DOCX заявлялись, але читались як звичайний текст, ліміти не перевірялись, сторінка результатів показувала одні й ті самі вигадані дані, а обсяги пошуку, CPC й конкуренція ключових слів не мали джерела. Кабінет (вхід, реєстрація, історія, проєкти, тарифи, експорт у PDF) був набором макетів без бекенду.
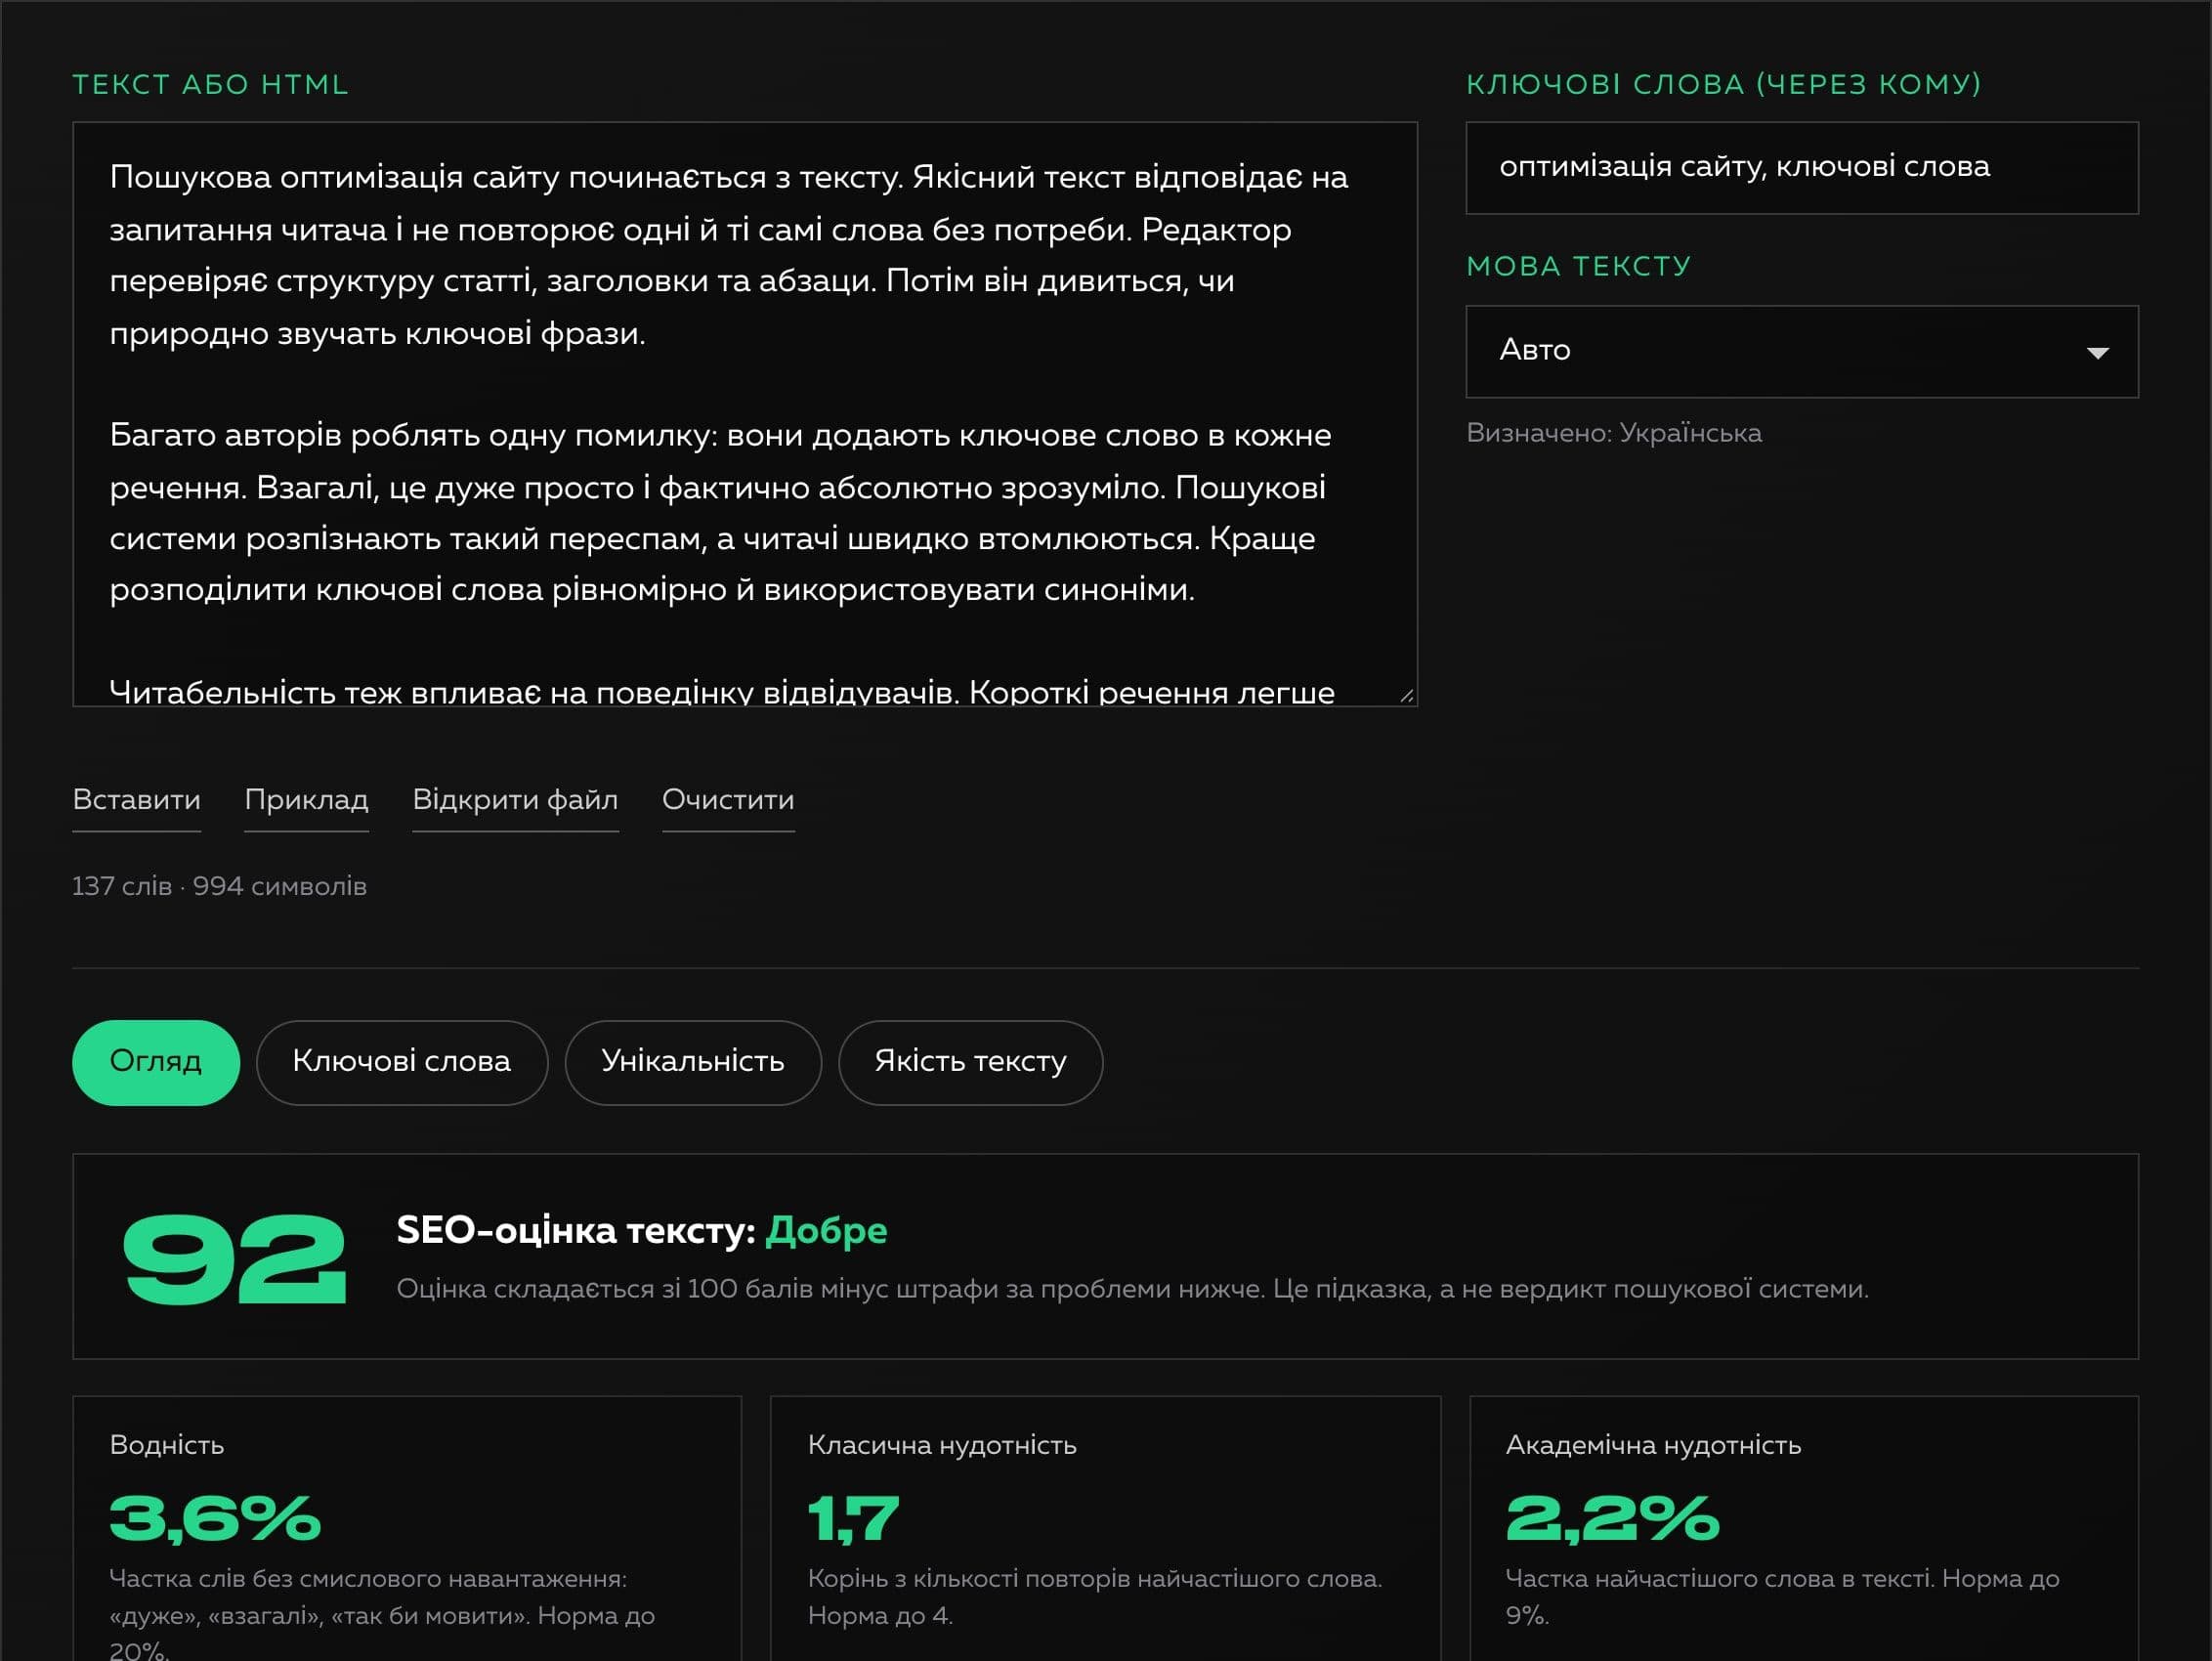
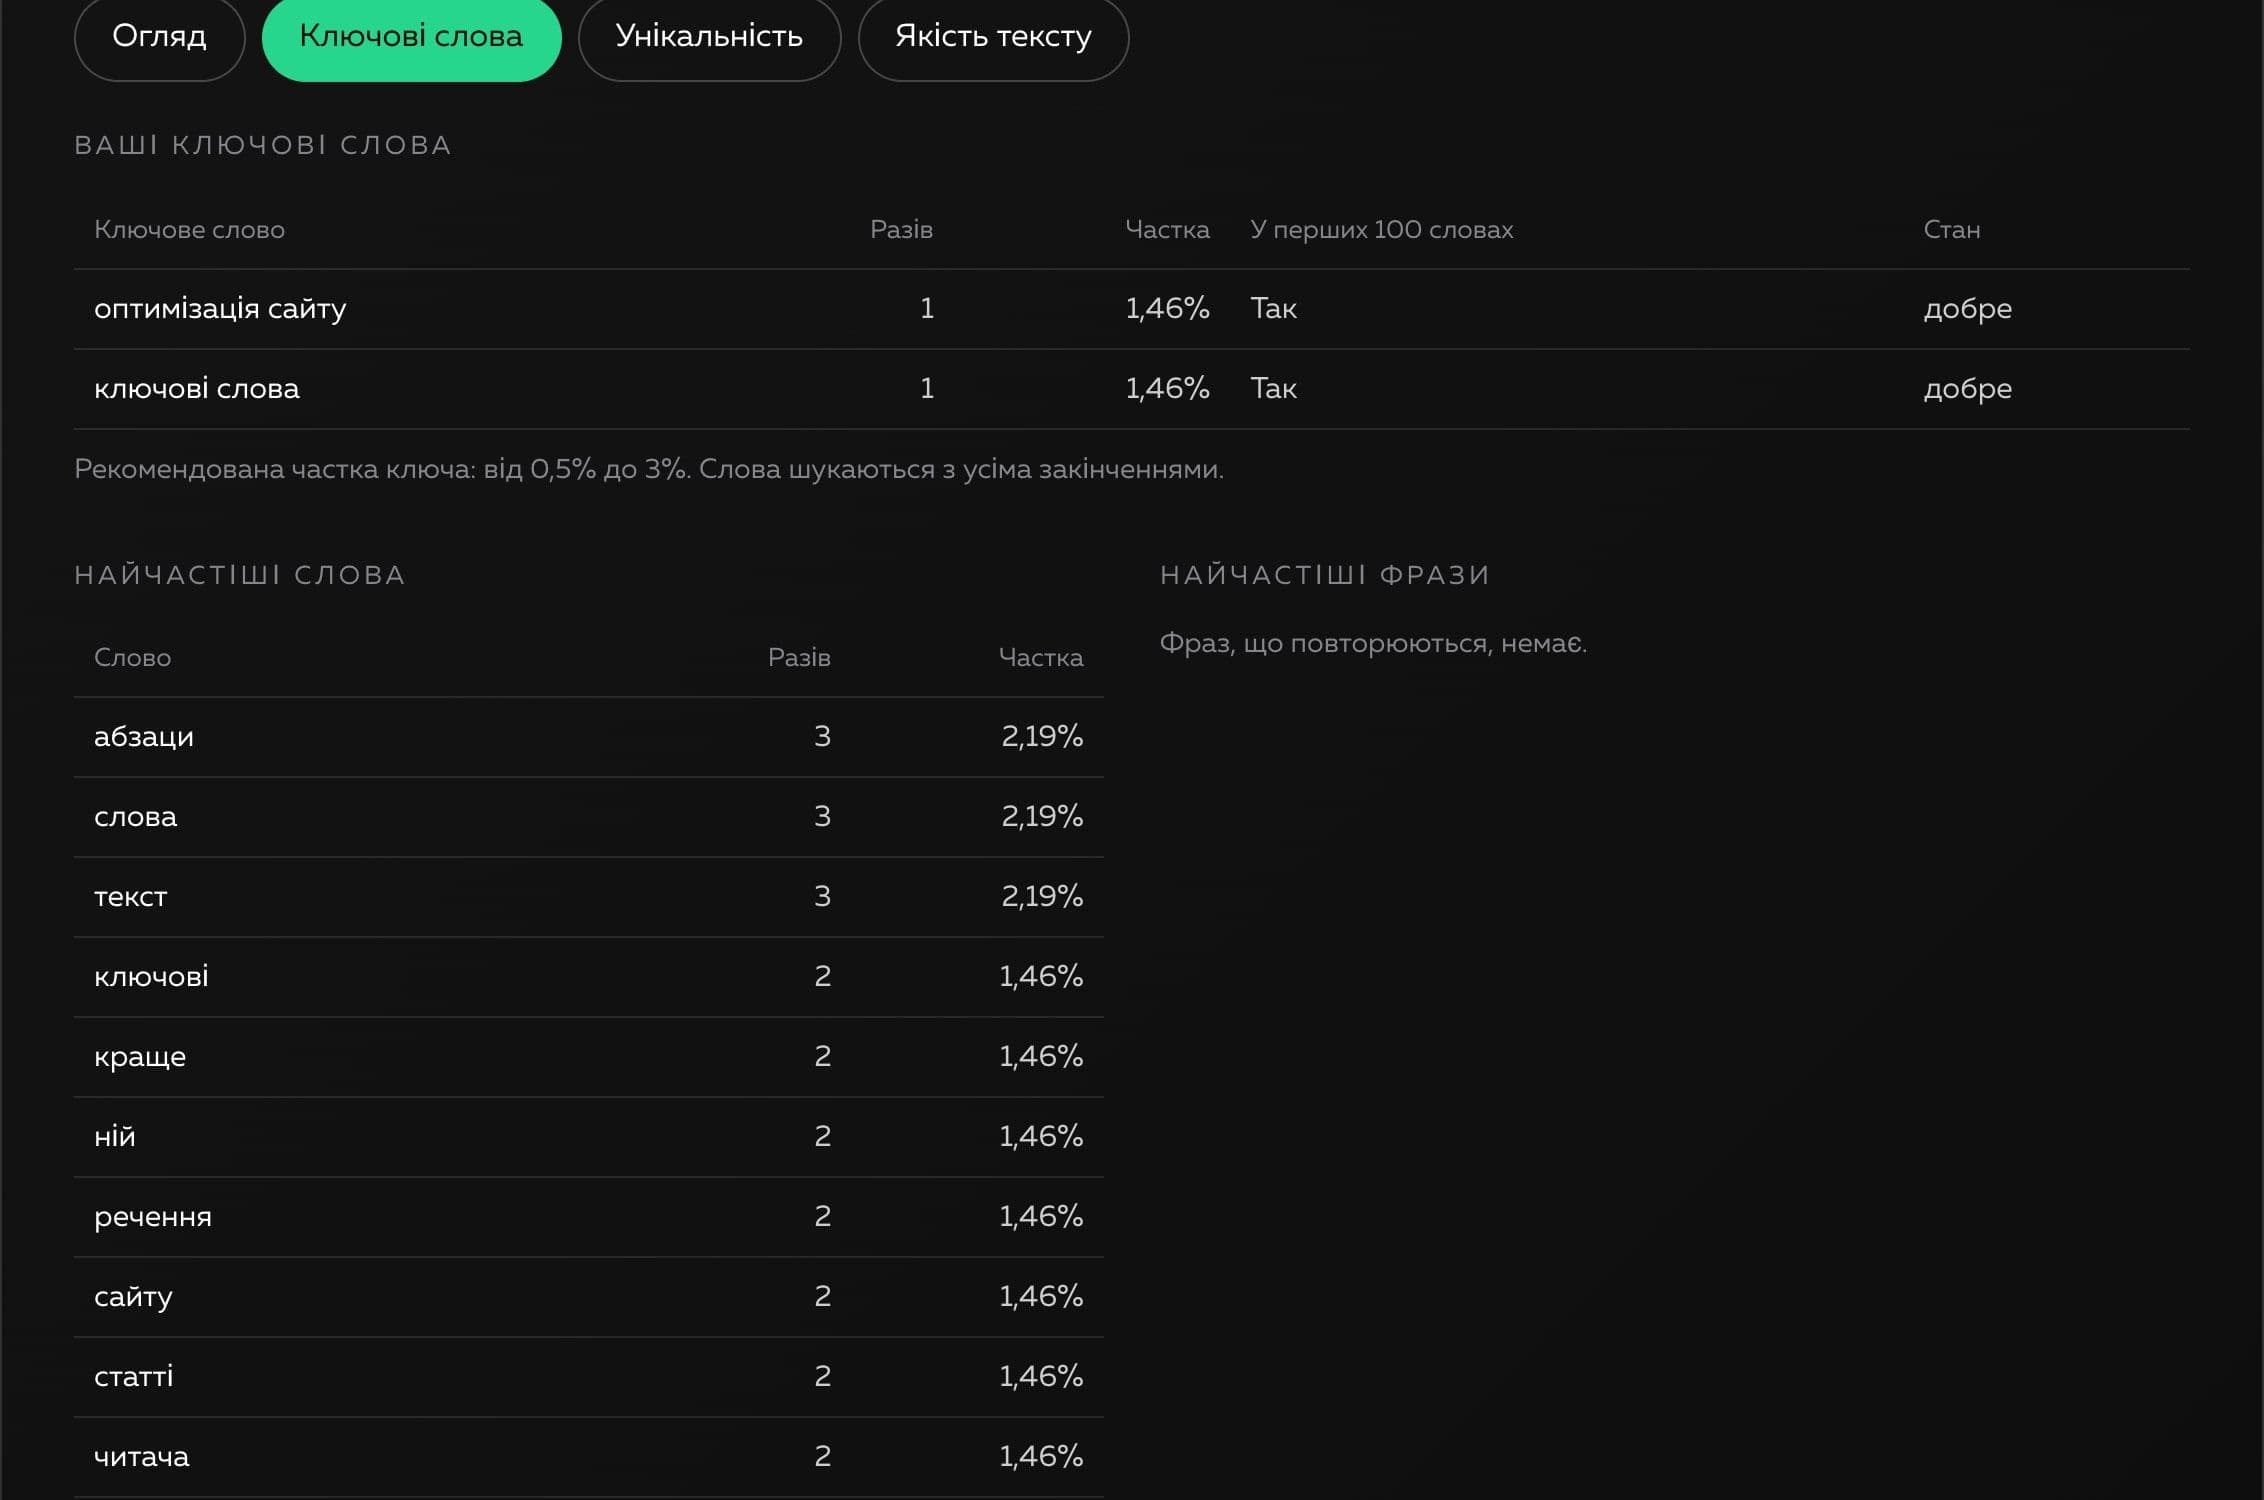
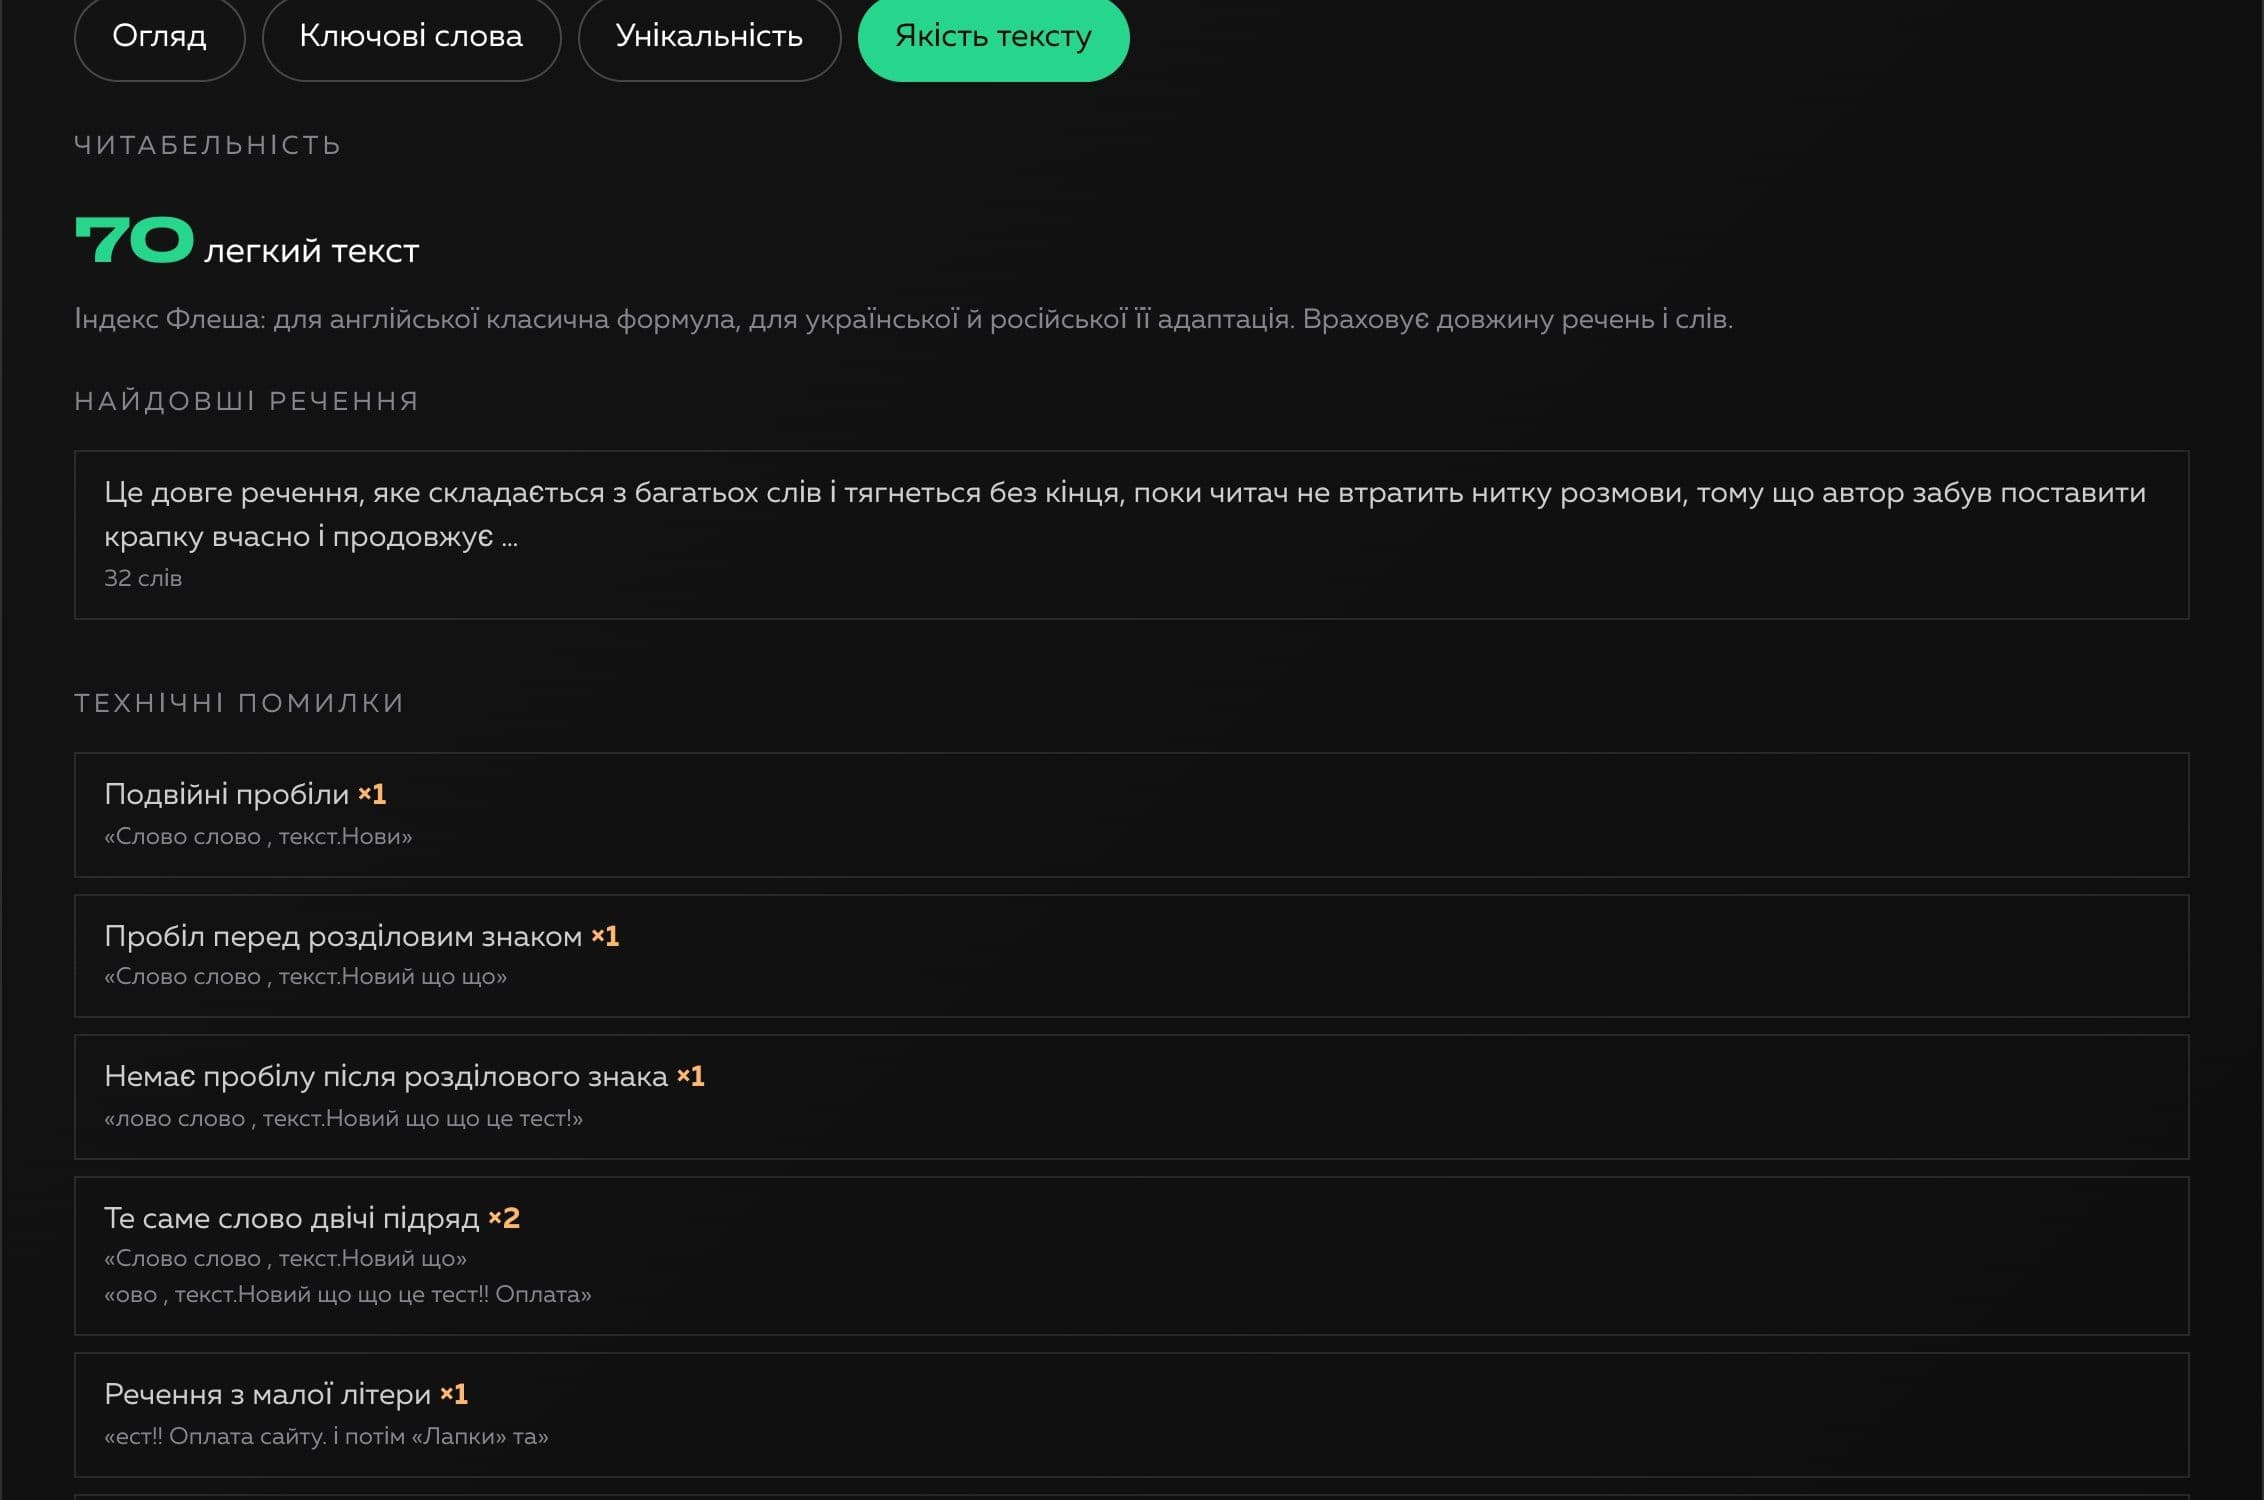
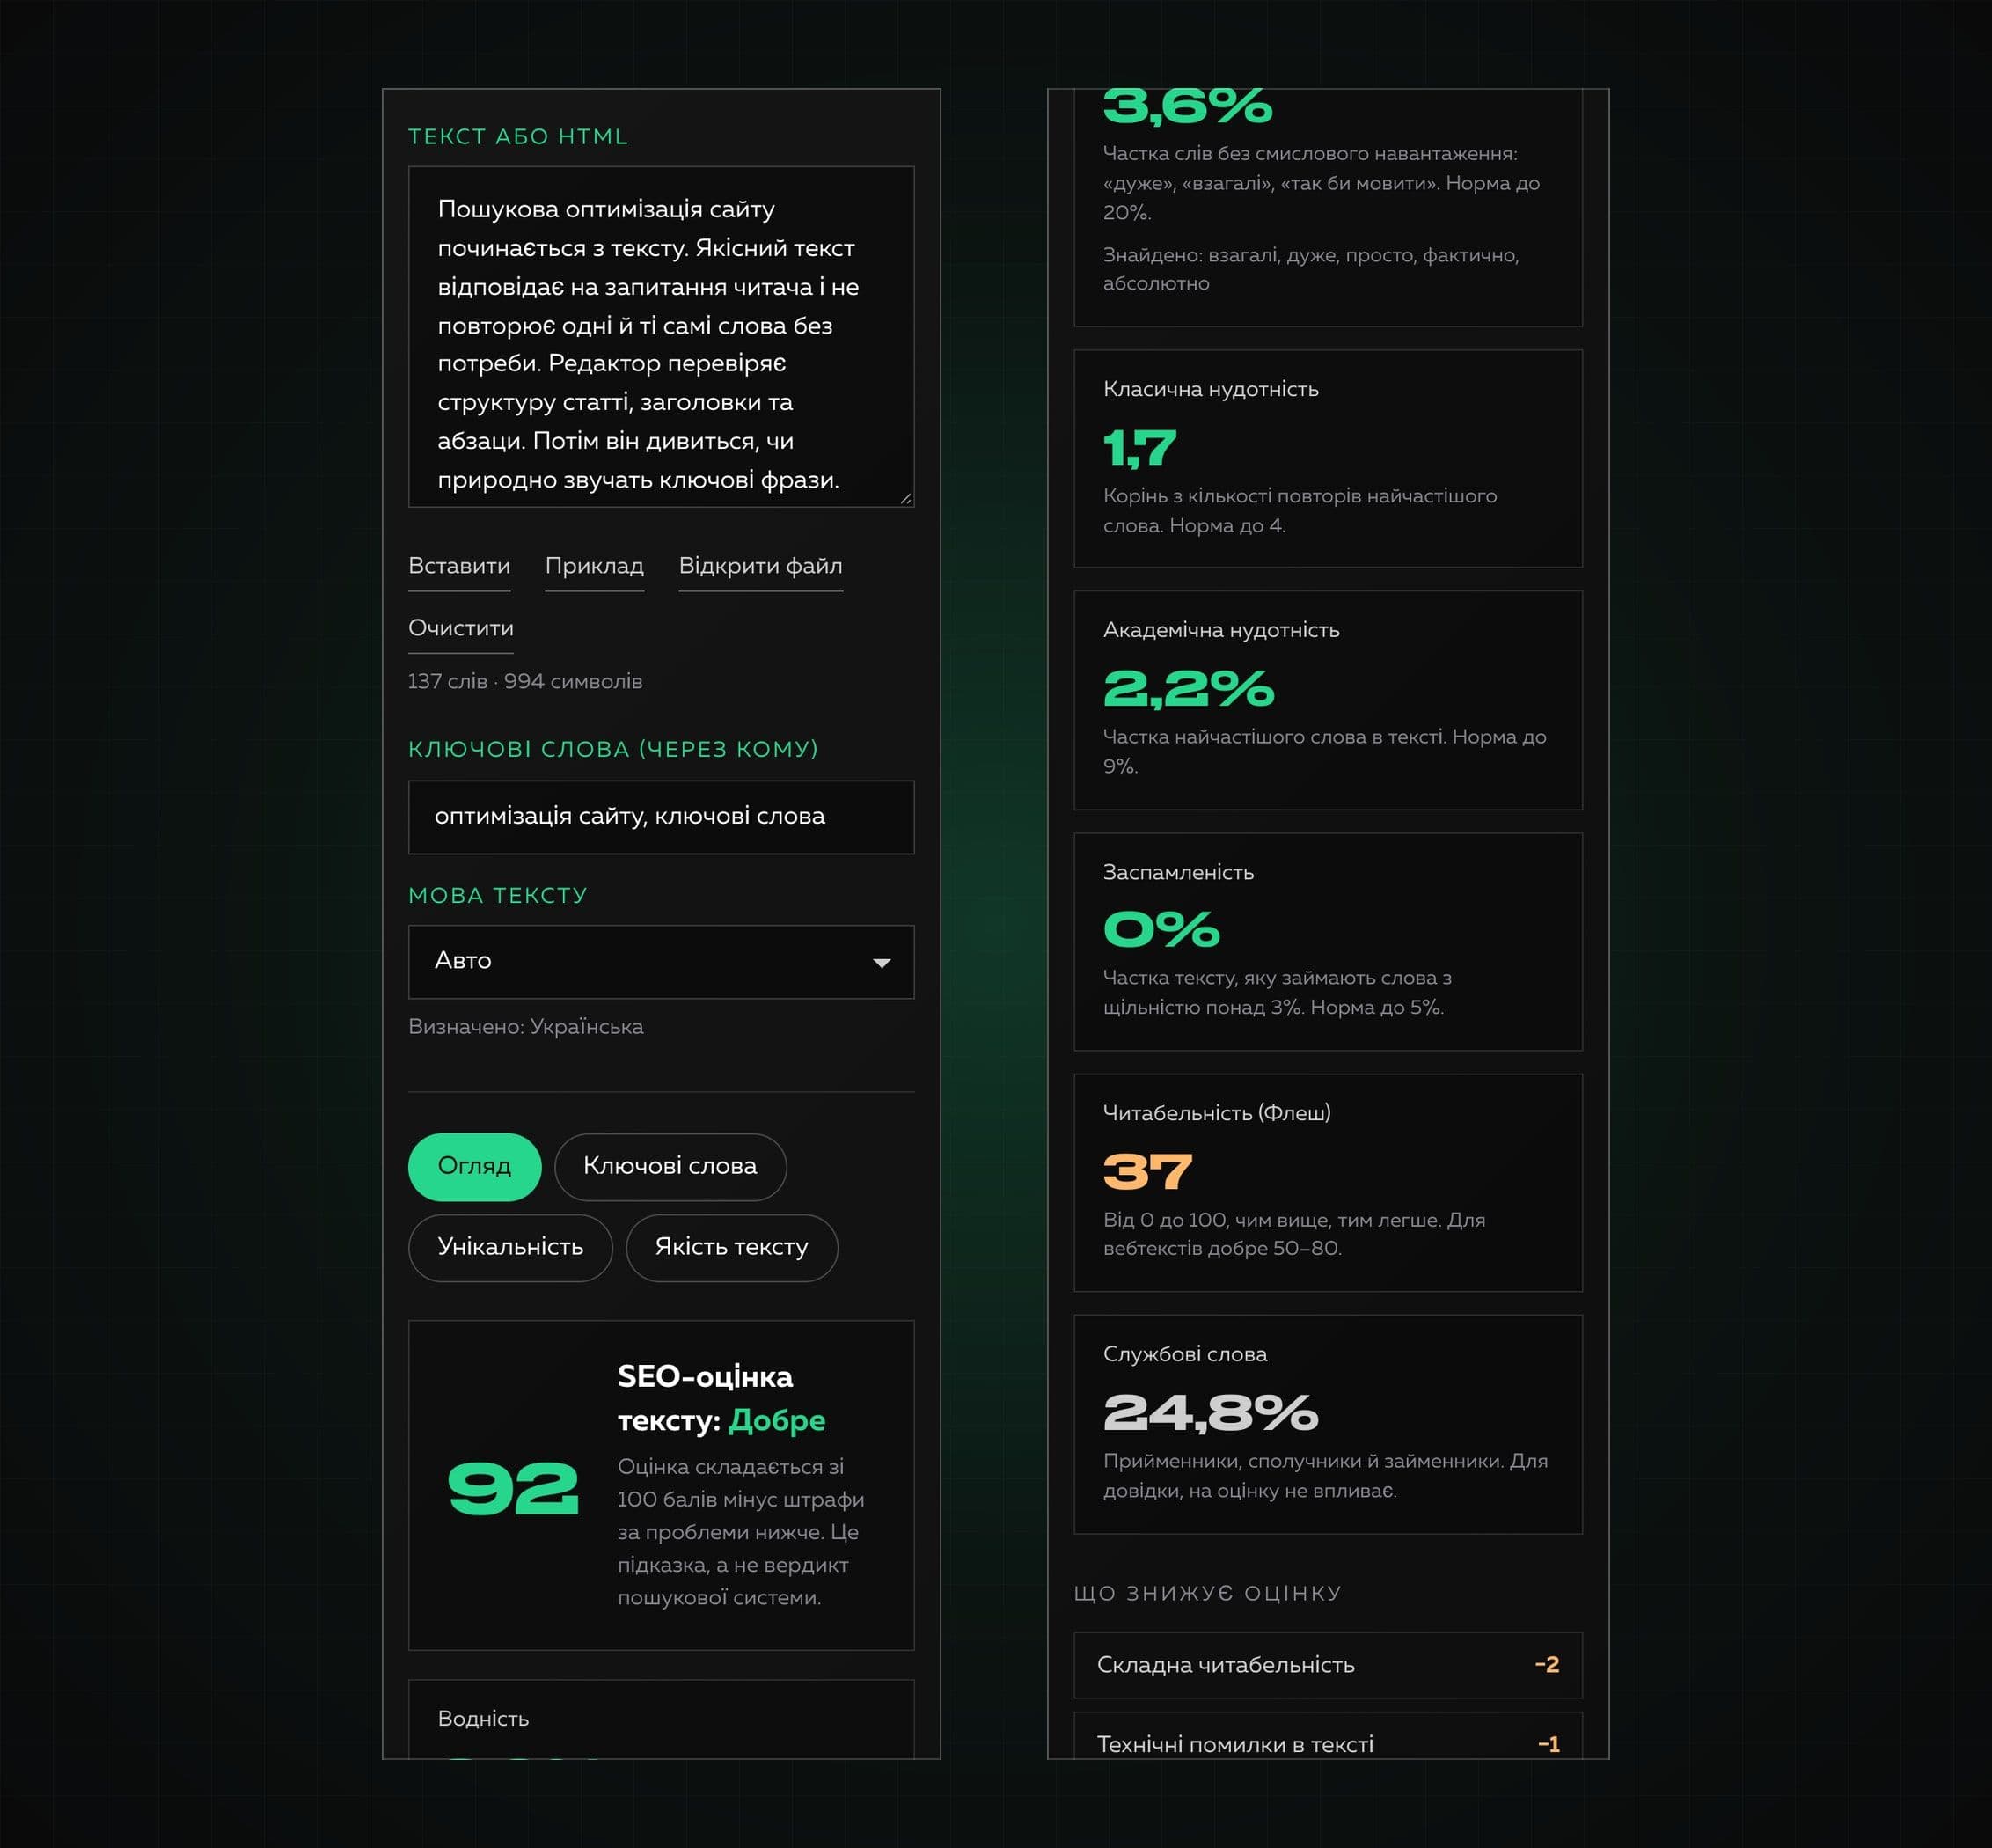
Ми написали справжню логіку. Показники рахуються за прозорими формулами: водність як частка слів і фраз без смислового навантаження, класична нудотність як корінь з повторів найчастішого слова, академічна як його частка, заспамленість як частка тексту зі словами понад 3% щільності, читабельність за Флешем (для української й російської в адаптації). Слова групуються стеммером, щоб «оптимізація», «оптимізації» й «оптимізацією» були одним словом. Є ключові слова та фрази, перевірка ваших ключів (кількість, щільність, наявність на початку), технічні помилки (подвійні пробіли, пробіл перед комою, повтор слова, латинська літера всередині кириличного слова, змішані лапки) і загальна оцінка, що розкладається на штрафи.
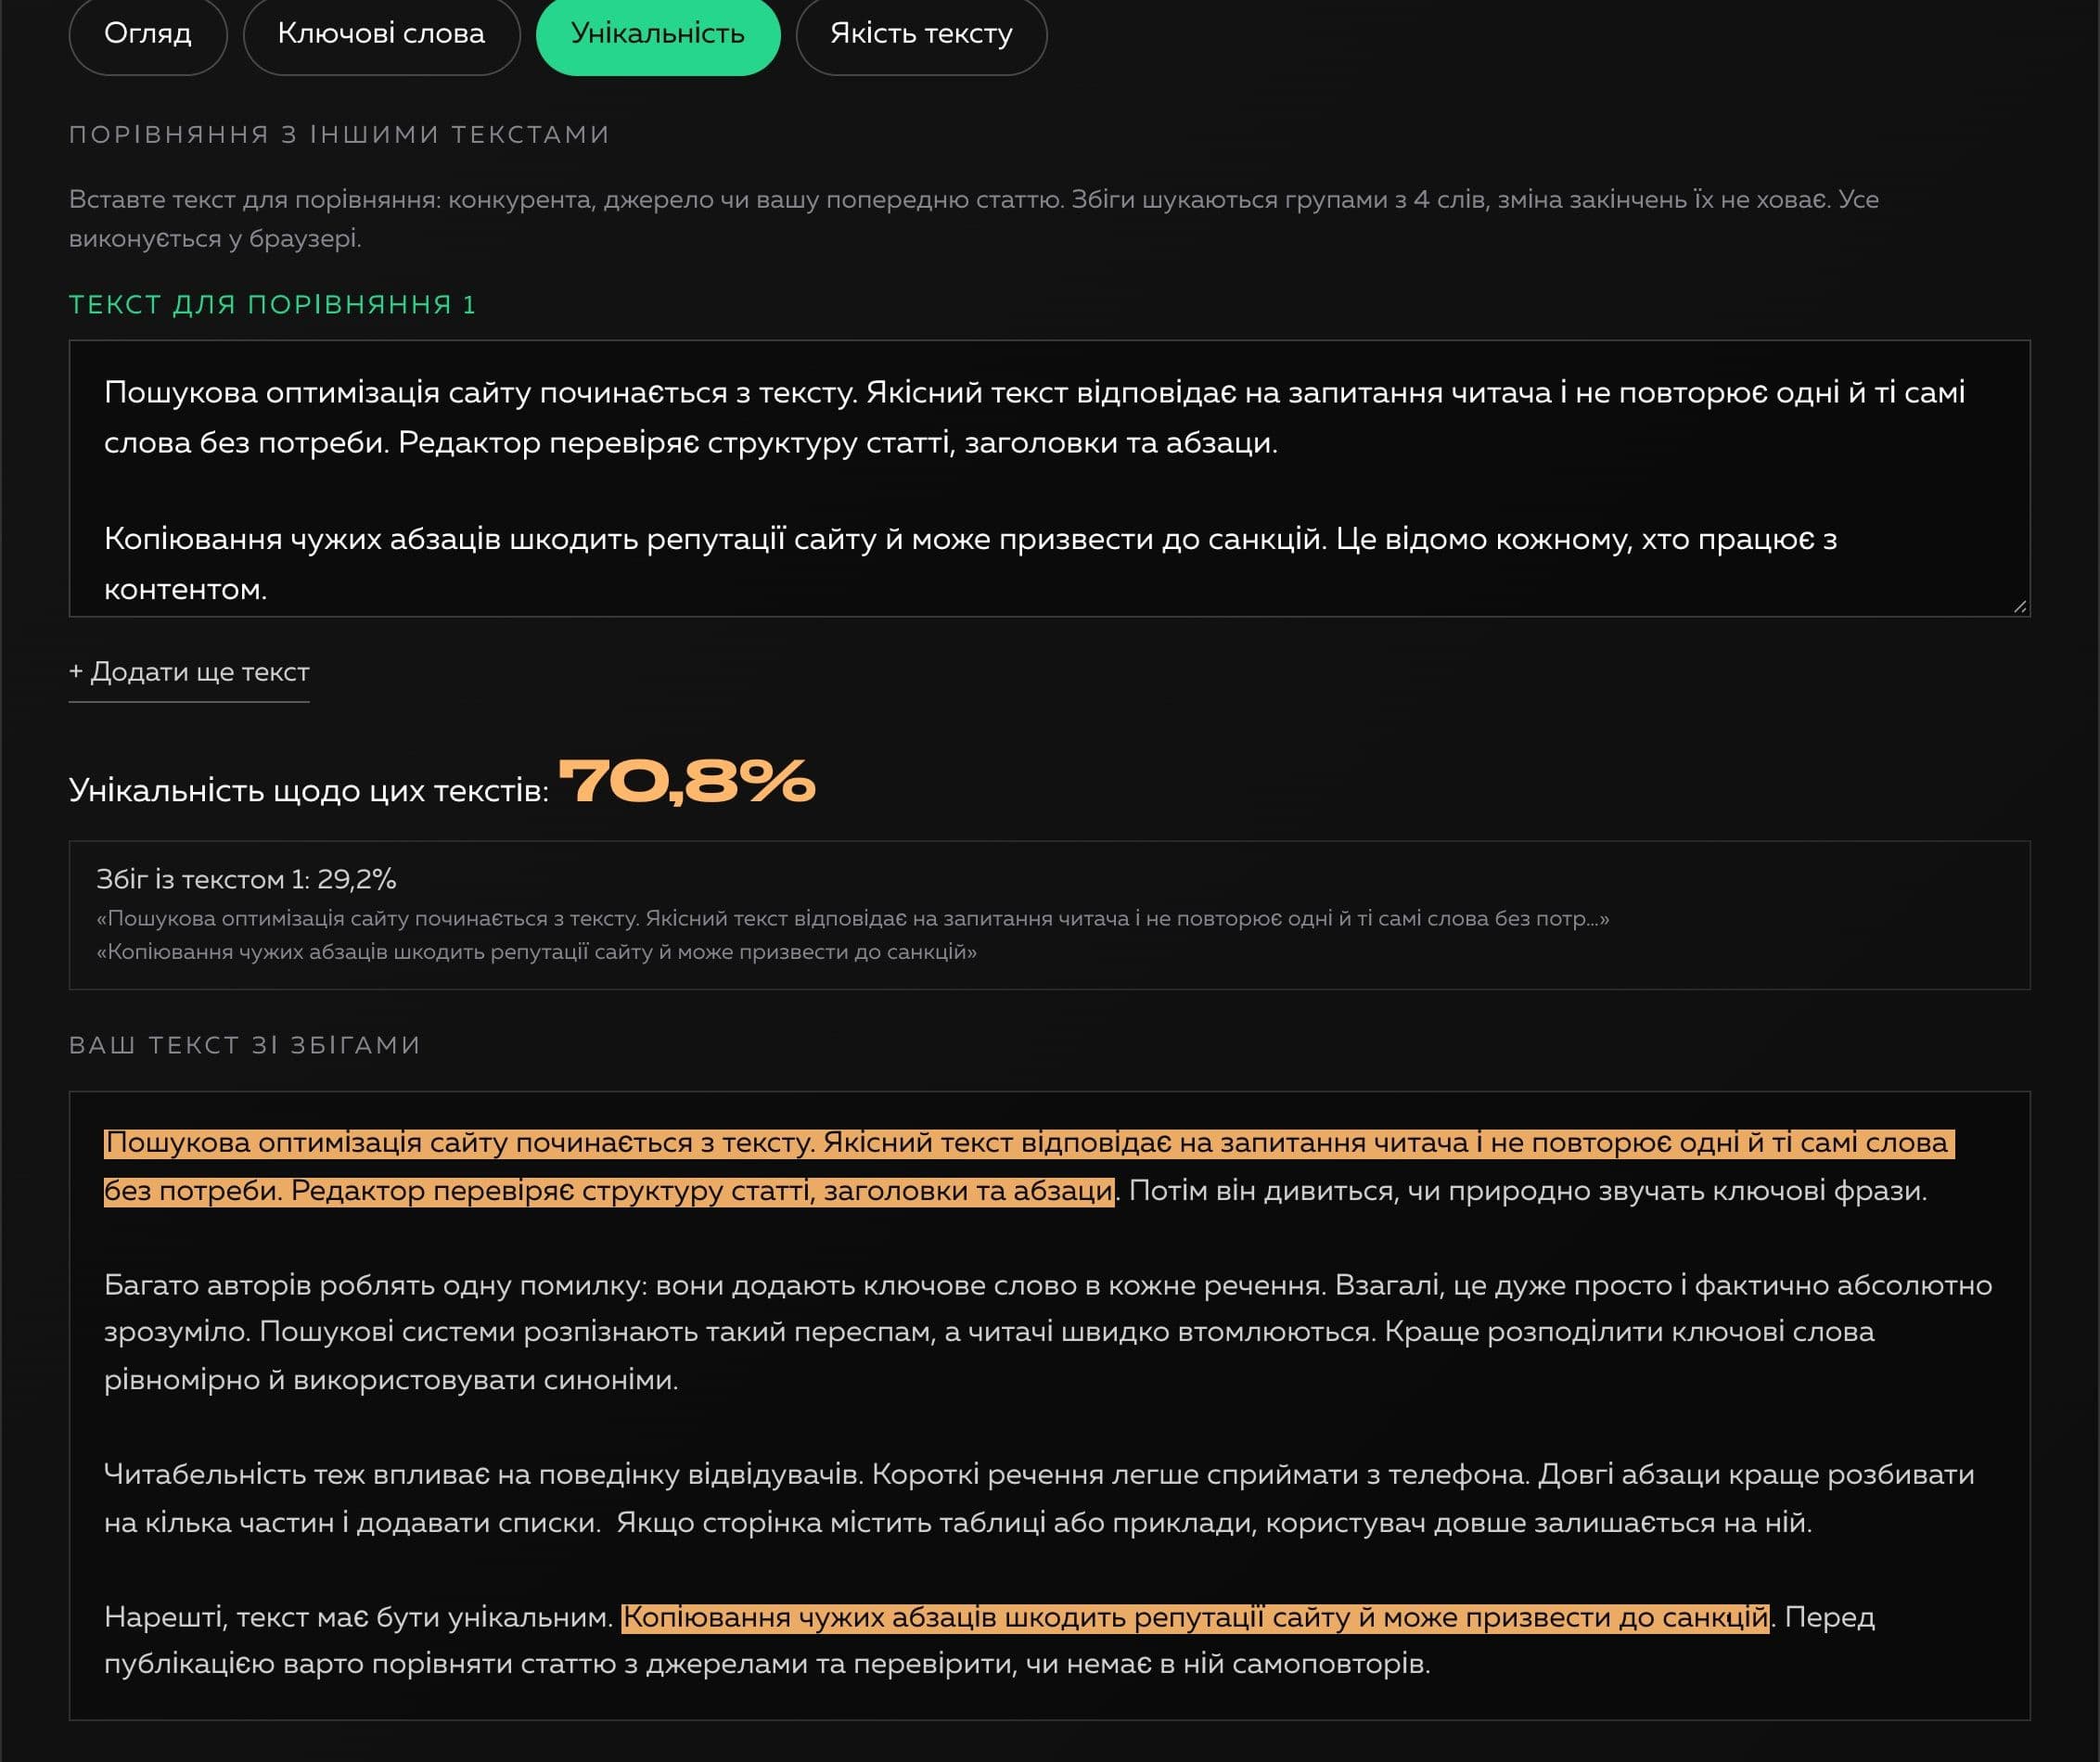
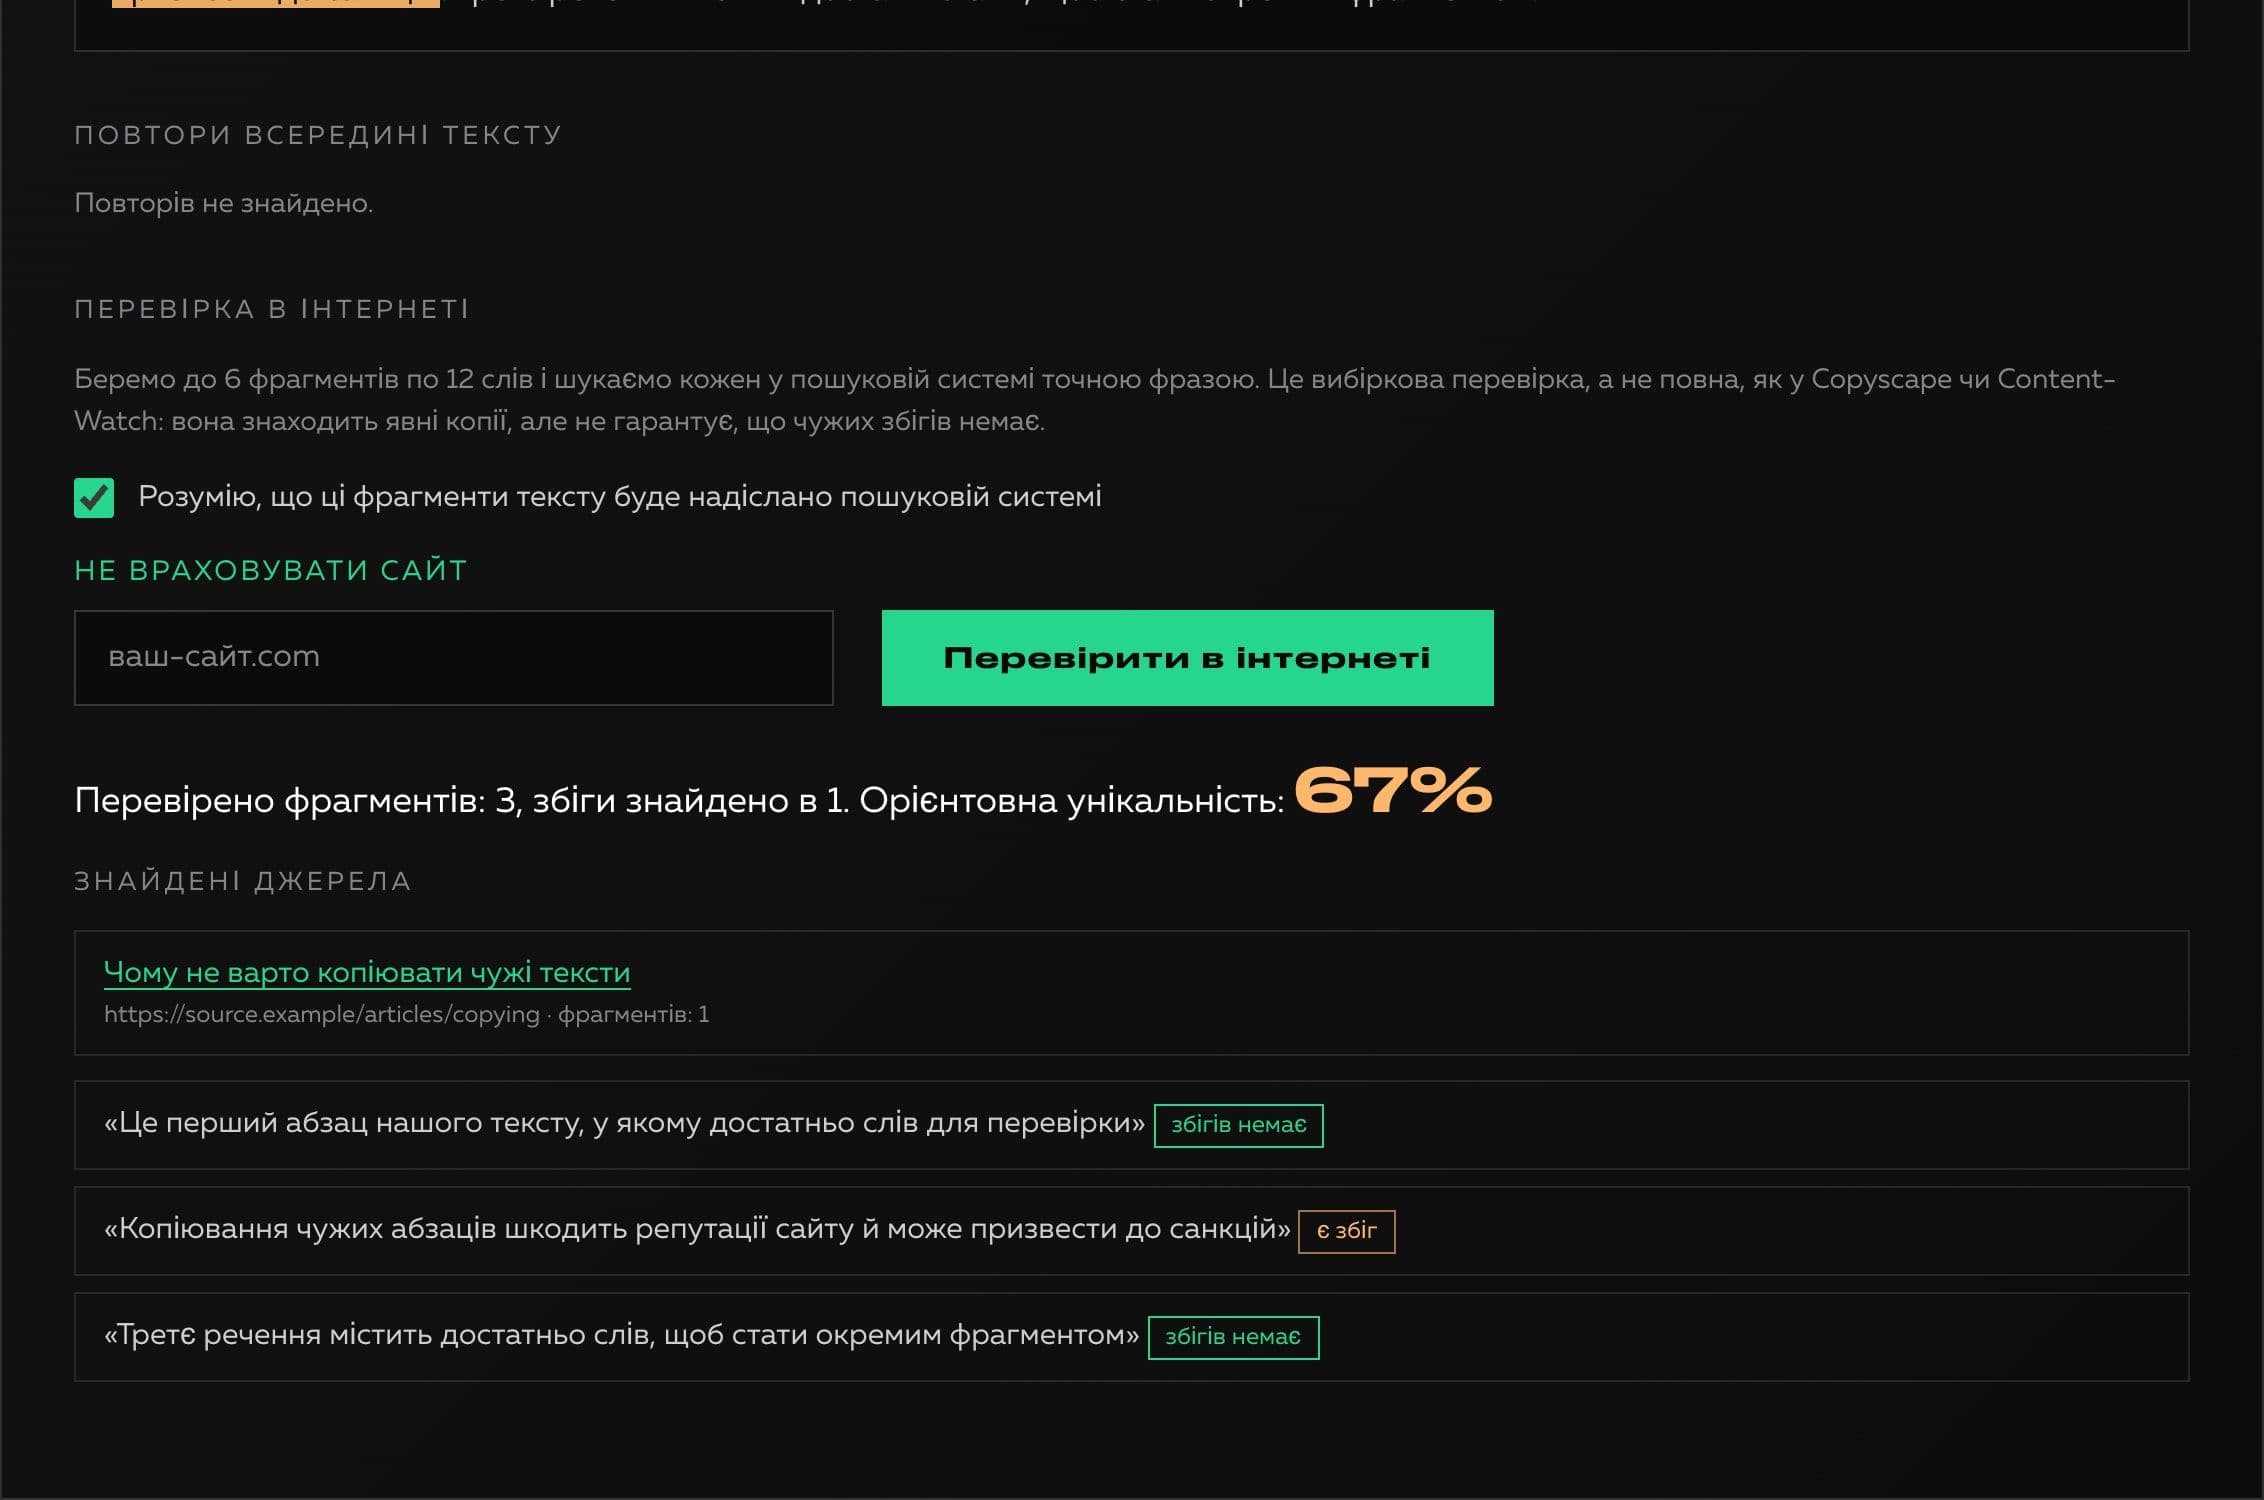
Унікальність перевіряється чесно. Завжди доступні порівняння з вашими текстами за групами слів із урахуванням закінчень, із підсвіткою збігів, і пошук повторів усередині тексту. Перевірка в інтернеті реалізована окремо, як вибіркова: серверний маршрут бере до шести фрагментів по 12 слів і шукає їх точною фразою через пошукове API (Brave або Google). Вона вмикається лише з ключем у налаштуваннях сервера, потребує згоди користувача, перевіряє джерело запиту й обмежує частоту. Ключ не потрапляє в браузер, а збіг підтверджується тільки якщо знайдений опис справді містить фрагмент. Ми прямо пишемо в інтерфейсі, що це не повна база на кшталт Copyscape чи Content-Watch.
Інтерфейс повністю переробили під дизайн сайту Creomatix. Перевірили 92 перевірки логіки на українських та англійських текстах, 67 наскрізних перевірок у Chrome (разом із перевіркою маршруту й імітованим пошуковим API: заголовок із ключем, цитована фраза, відсікання чужих запитів, ліміти) і мобільну версію. Аналіз тексту на 330 КБ виконується приблизно за півсекунди. Зверніть увагу: роботу з живим Brave чи Google ми не перевіряли, бо для цього потрібен ключ.
Технології
- Next.js (Pages Router, API-маршрут)
- React
- TypeScript
- SCSS Modules
- Власні токенізатор, стеммер і шинглінг
- Brave Search API та Google Programmable Search
- Strapi (контент сторінки продукту)
Який функціонал створили?
- Водність, класична й академічна нудотність, заспамленість, читабельність за Флешем
- Найчастіші слова й фрази зі стемінгом, перевірка ваших ключових слів
- Українська, російська й англійська мови, автовизначення
- Загальна SEO-оцінка, що розкладається на видимі штрафи
- Технічні помилки: пробіли, повтори слів, змішані алфавіти, лапки, речення з малої літери
- Порівняння з до п’яти іншими текстами з підсвіткою збігів
- Пошук повторів усередині тексту
- Вибіркова перевірка в інтернеті через Brave або Google API, з окремою згодою користувача
- Захист маршруту: перевірка походження запиту, ліміти, відсутність ключа в браузері, нічого не зберігається
- Вхід у вигляді тексту, HTML-коду або файлів .txt і .html
- Версії інтерфейсу українською й англійською
Що отримав клієнт?
У результаті з’явився інструмент, який замість вигаданих цифр показує пояснювані показники, порівнює тексти й чесно говорить, що саме перевірено. Він працює без реєстрації й переважно у браузері та став сьомим продуктом у розділі «Продукти» нашого сайту.