Розпізнавання тексту з фото
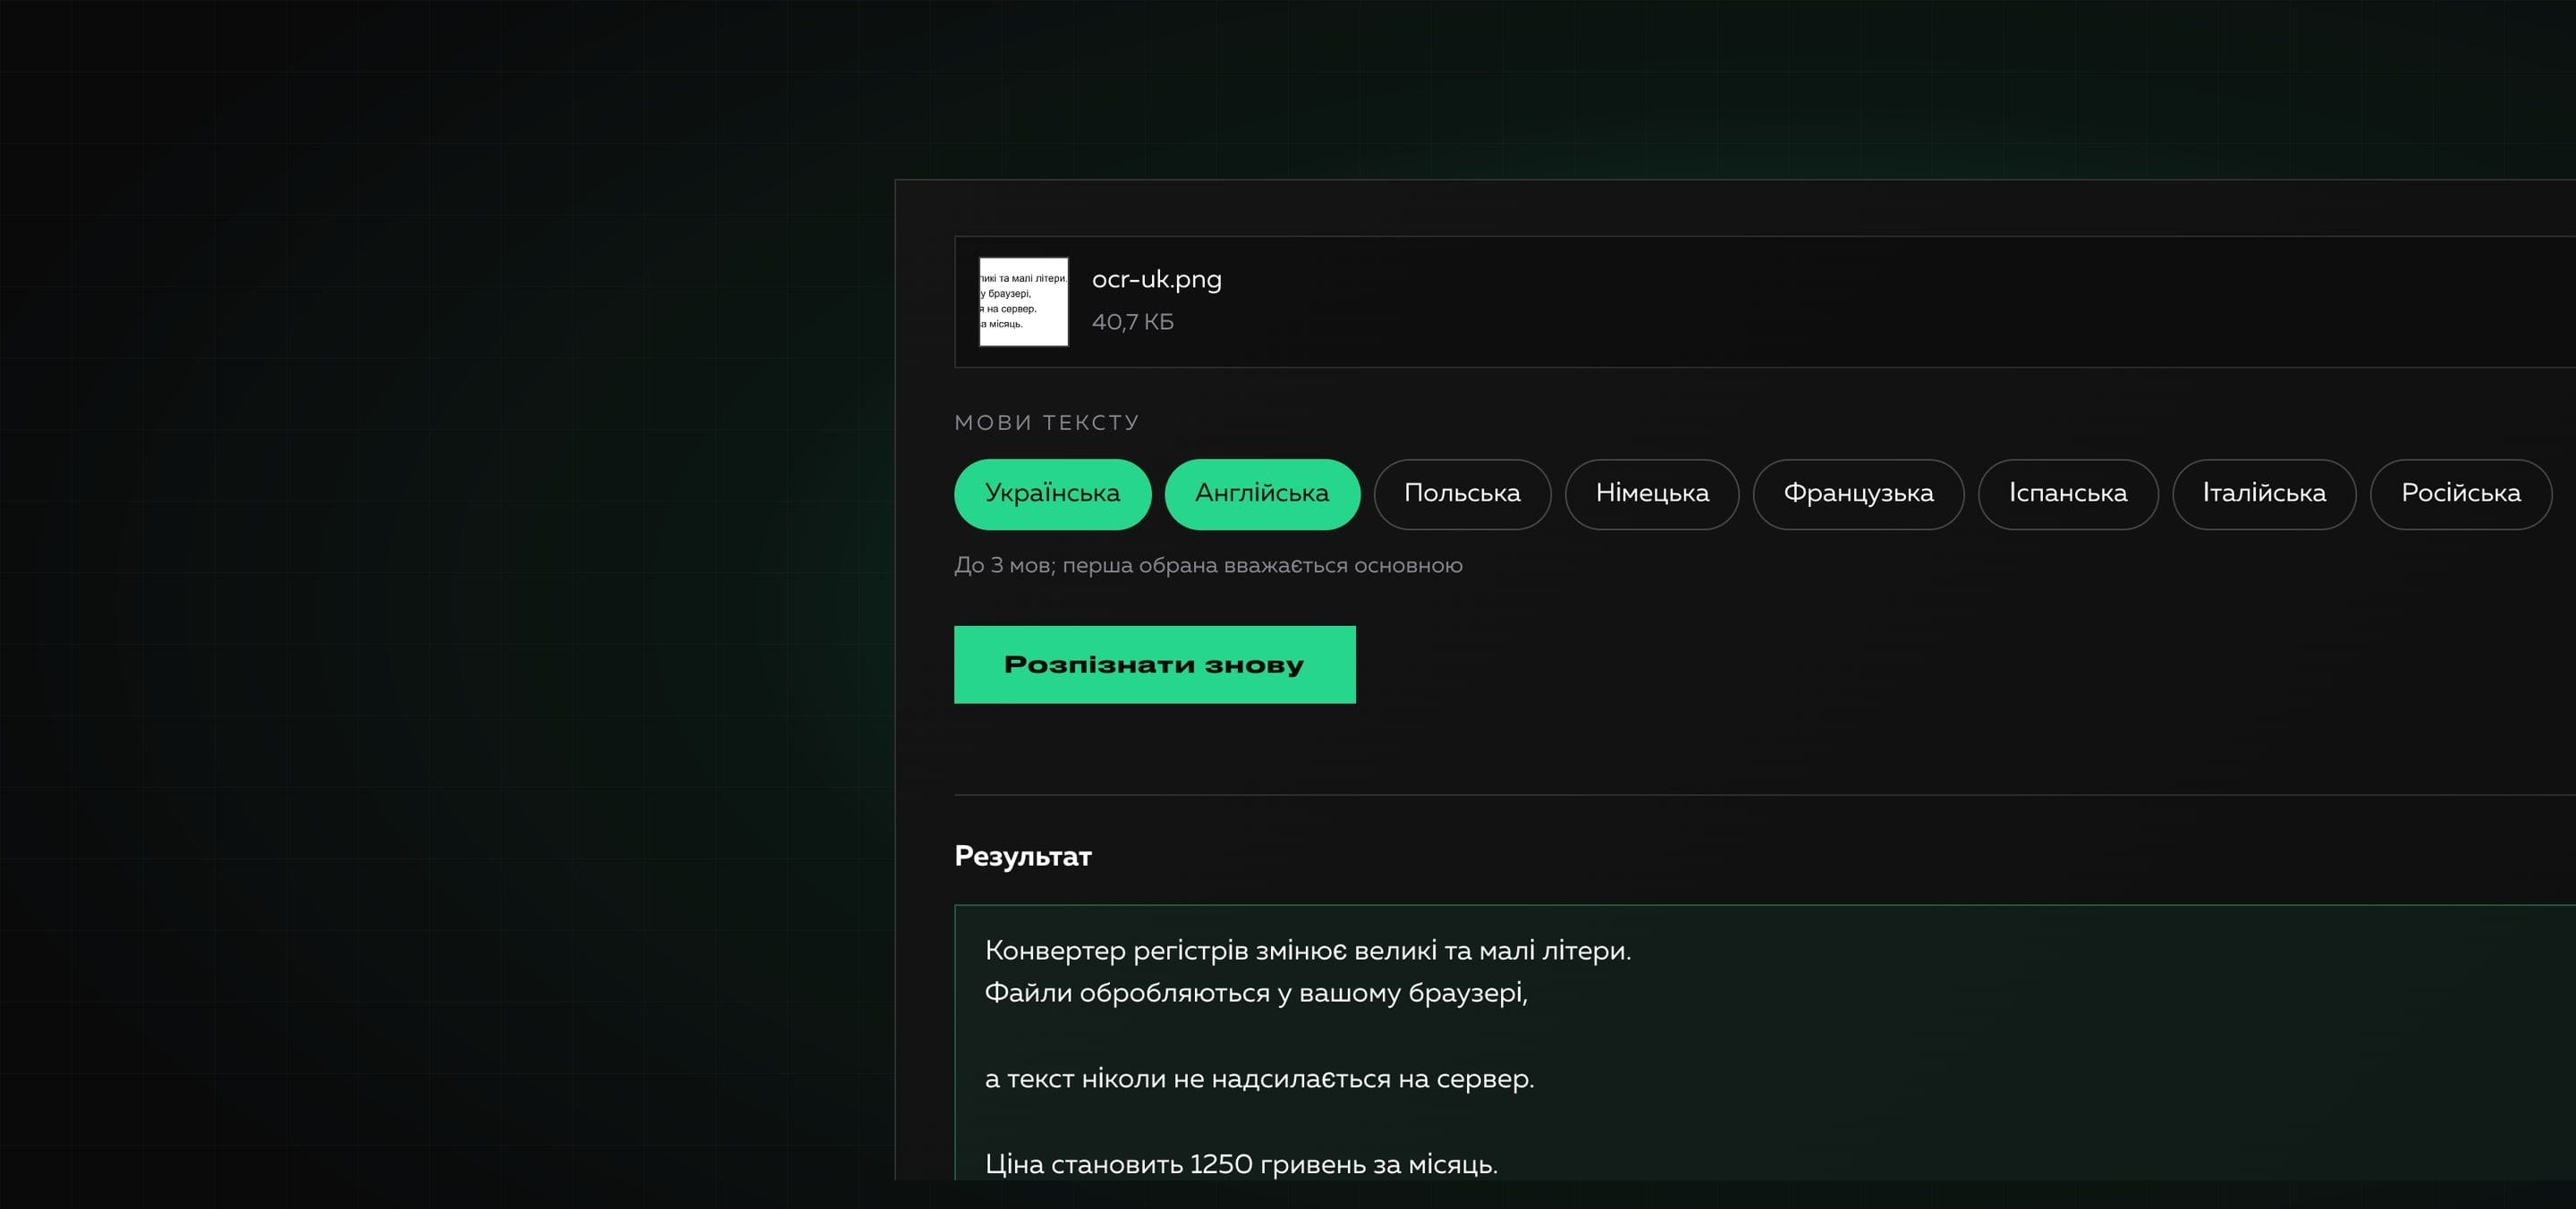
Розпізнавання тексту з фото (OCR) — це власний продукт Creomatix: онлайн-інструмент, який дістає текст із фото, скриншотів і PDF. Він працює на відкритому рушії Tesseract у браузері, а файли та рушій не залишають наш сайт. Спробувати його можна на сторінці «Розпізнавання тексту з фото», а про те, як отримати кращий результат, розповідаємо в блозі.
Що було зроблено?
Основою став прототип на tesseract.js. Перед запуском ми перевірили його в реальному браузері й помітили кілька суттєвих проблем. Рушій, WASM-ядро й мовні моделі за замовчуванням завантажувались зі стороннього CDN під час кожного запуску, тож заява «файли не залишають пристрій» була лише наполовину правдивою: браузер відвідувача звертався до чужого сервісу, а без нього інструмент не працював. PDF приймався й показував «готово до розпізнавання», але сама бібліотека PDF не читає, тож розпізнавання падало. Введення за посиланням у більшості випадків блокується політикою CORS чужих сайтів, а помилка нічого не пояснювала. Воркер не зупинявся при помилці, прогрес показувався лише на етапі розпізнавання (під час довгого першого завантаження моделей екран мовчав), скасувати розпізнавання було неможливо, а розраховану впевненість розпізнавання користувачу взагалі не показували. Також не було лімітів, а попередній перегляд будувався через base64, що навантажує пам’ять.
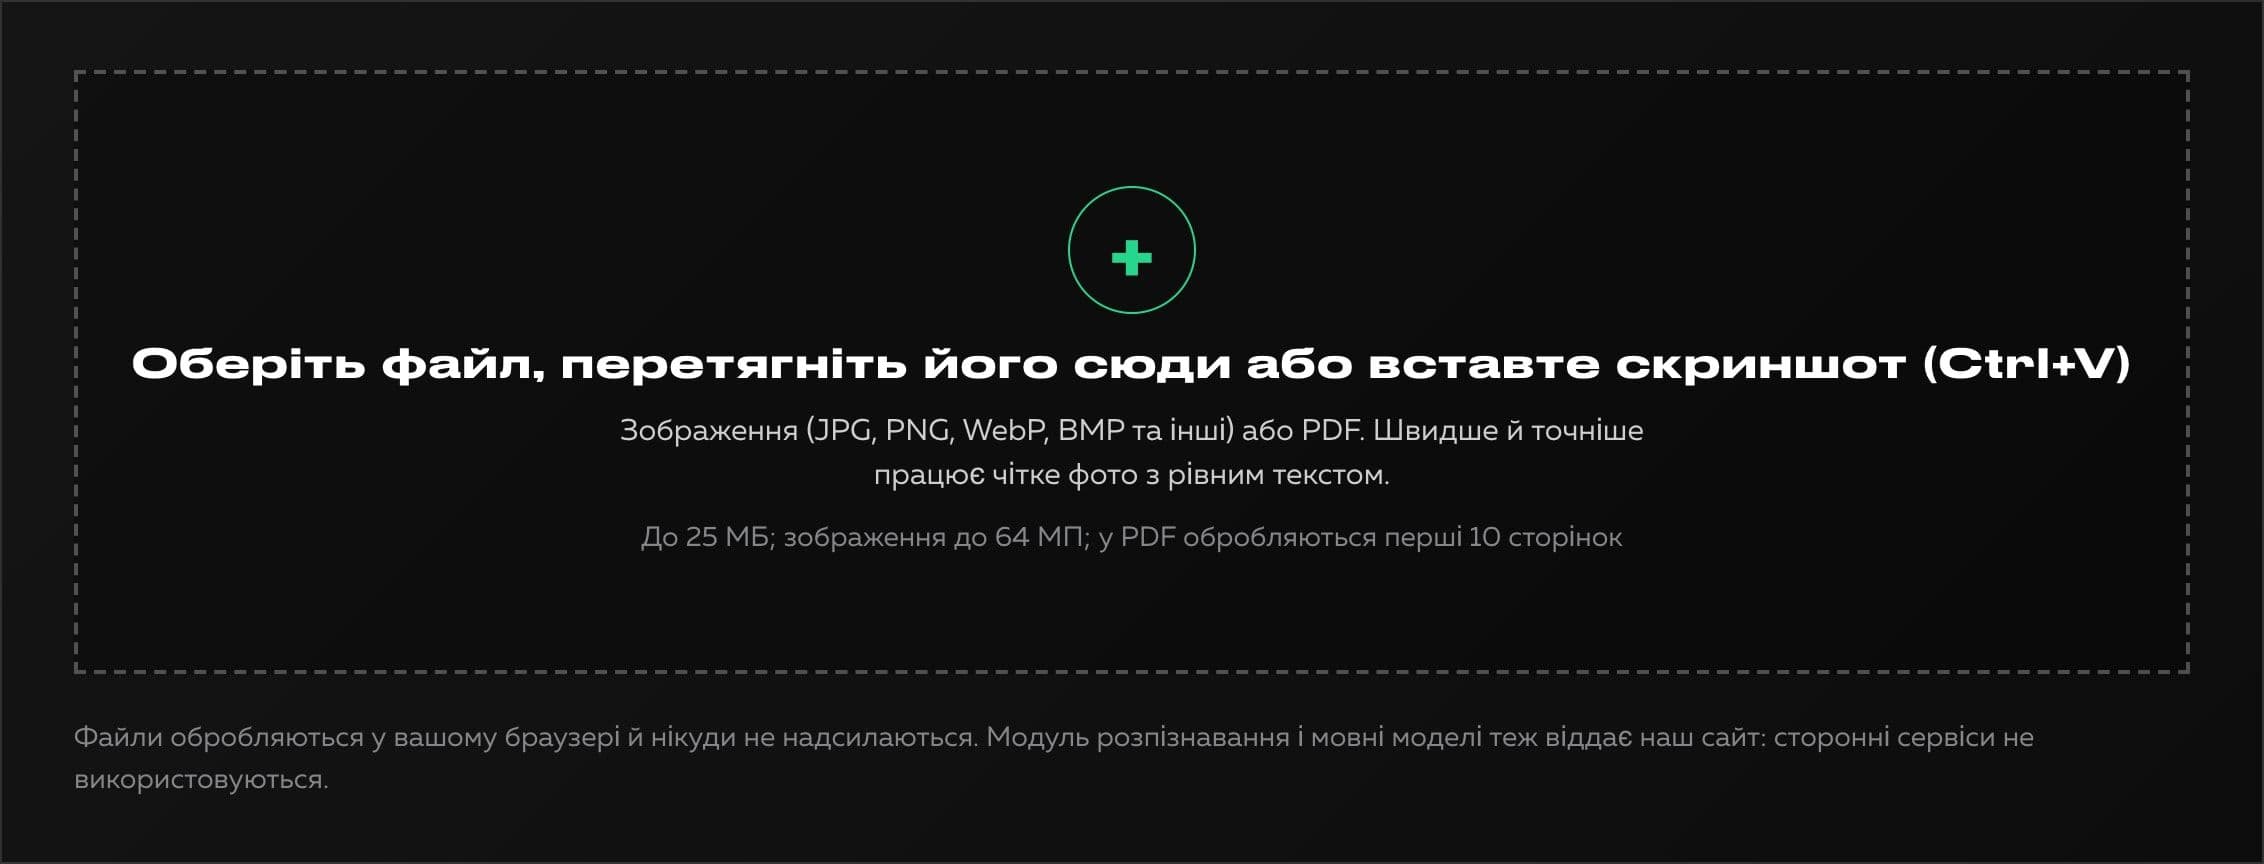
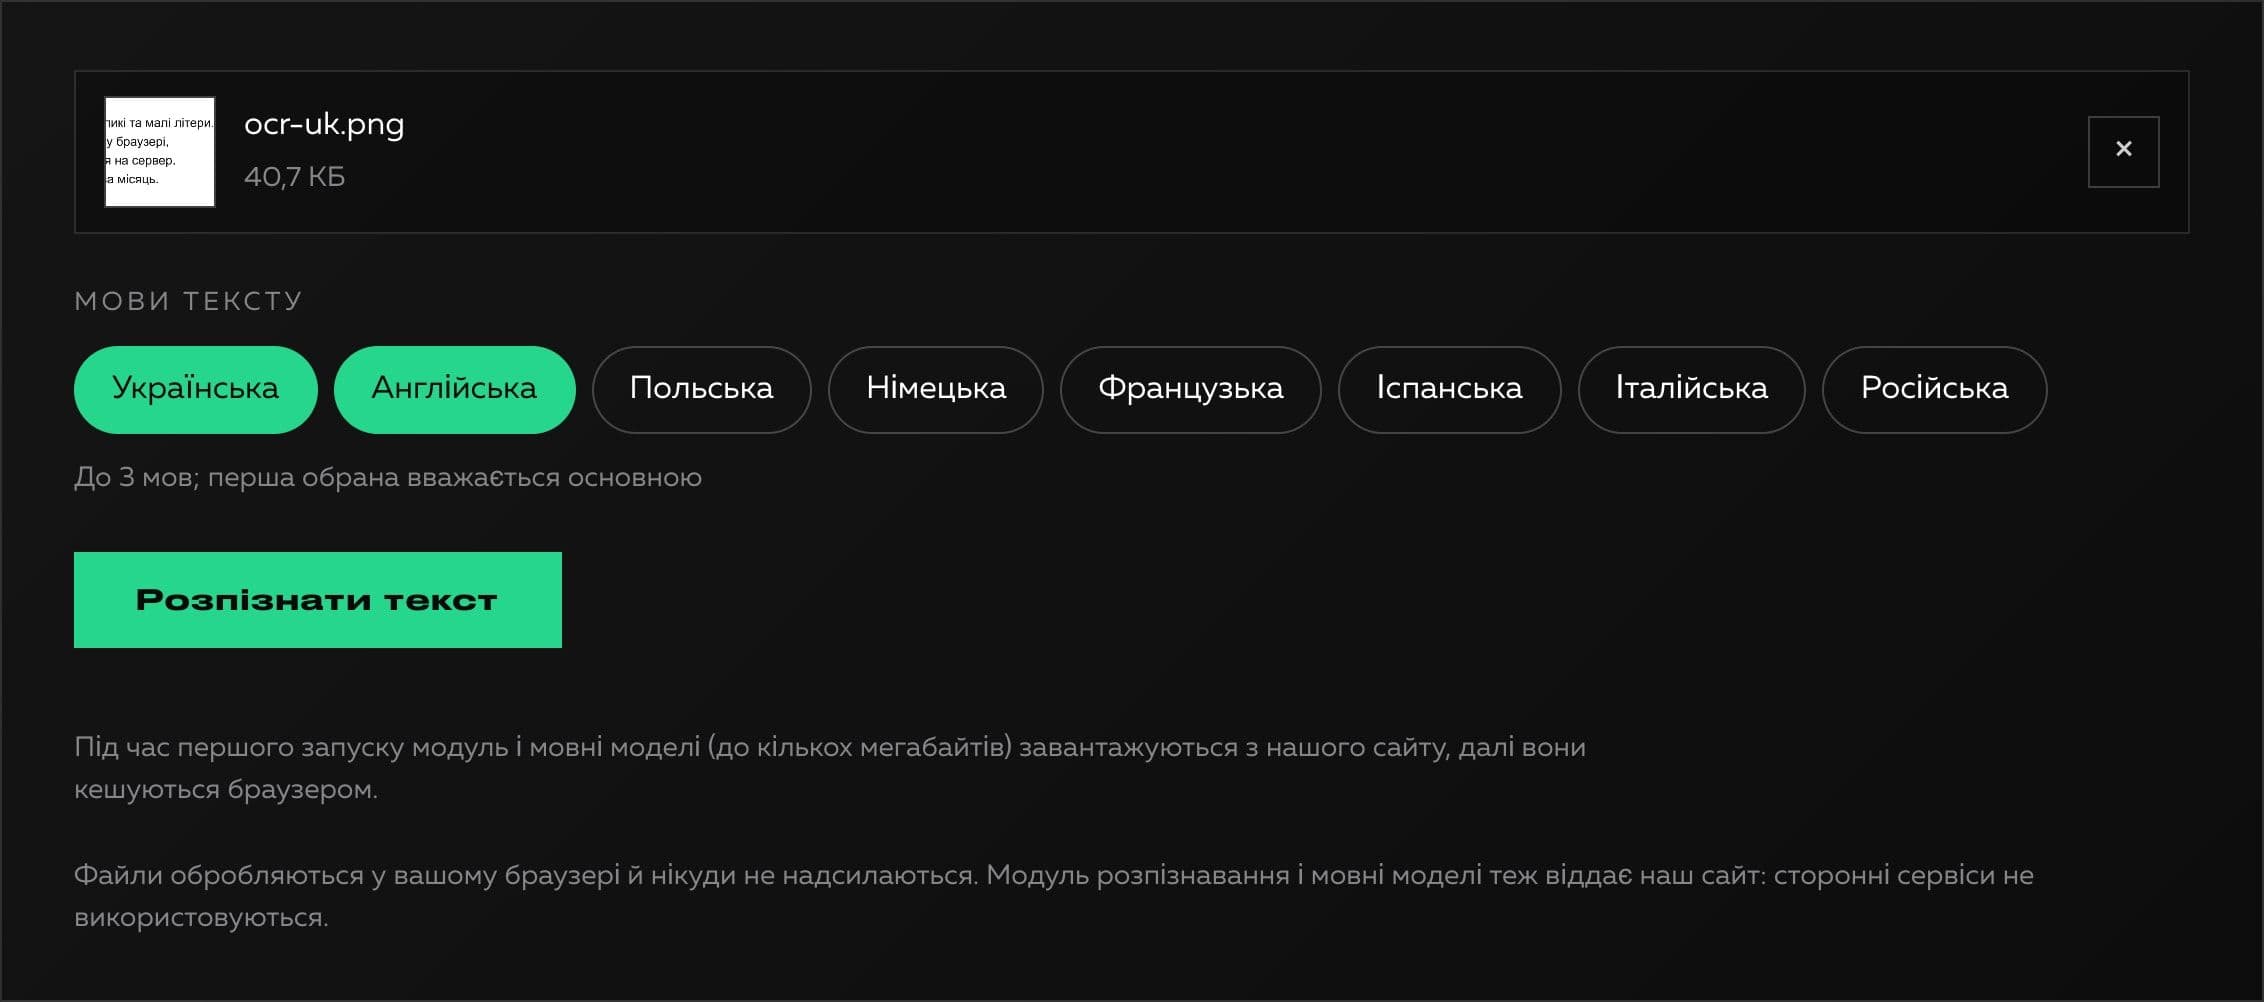
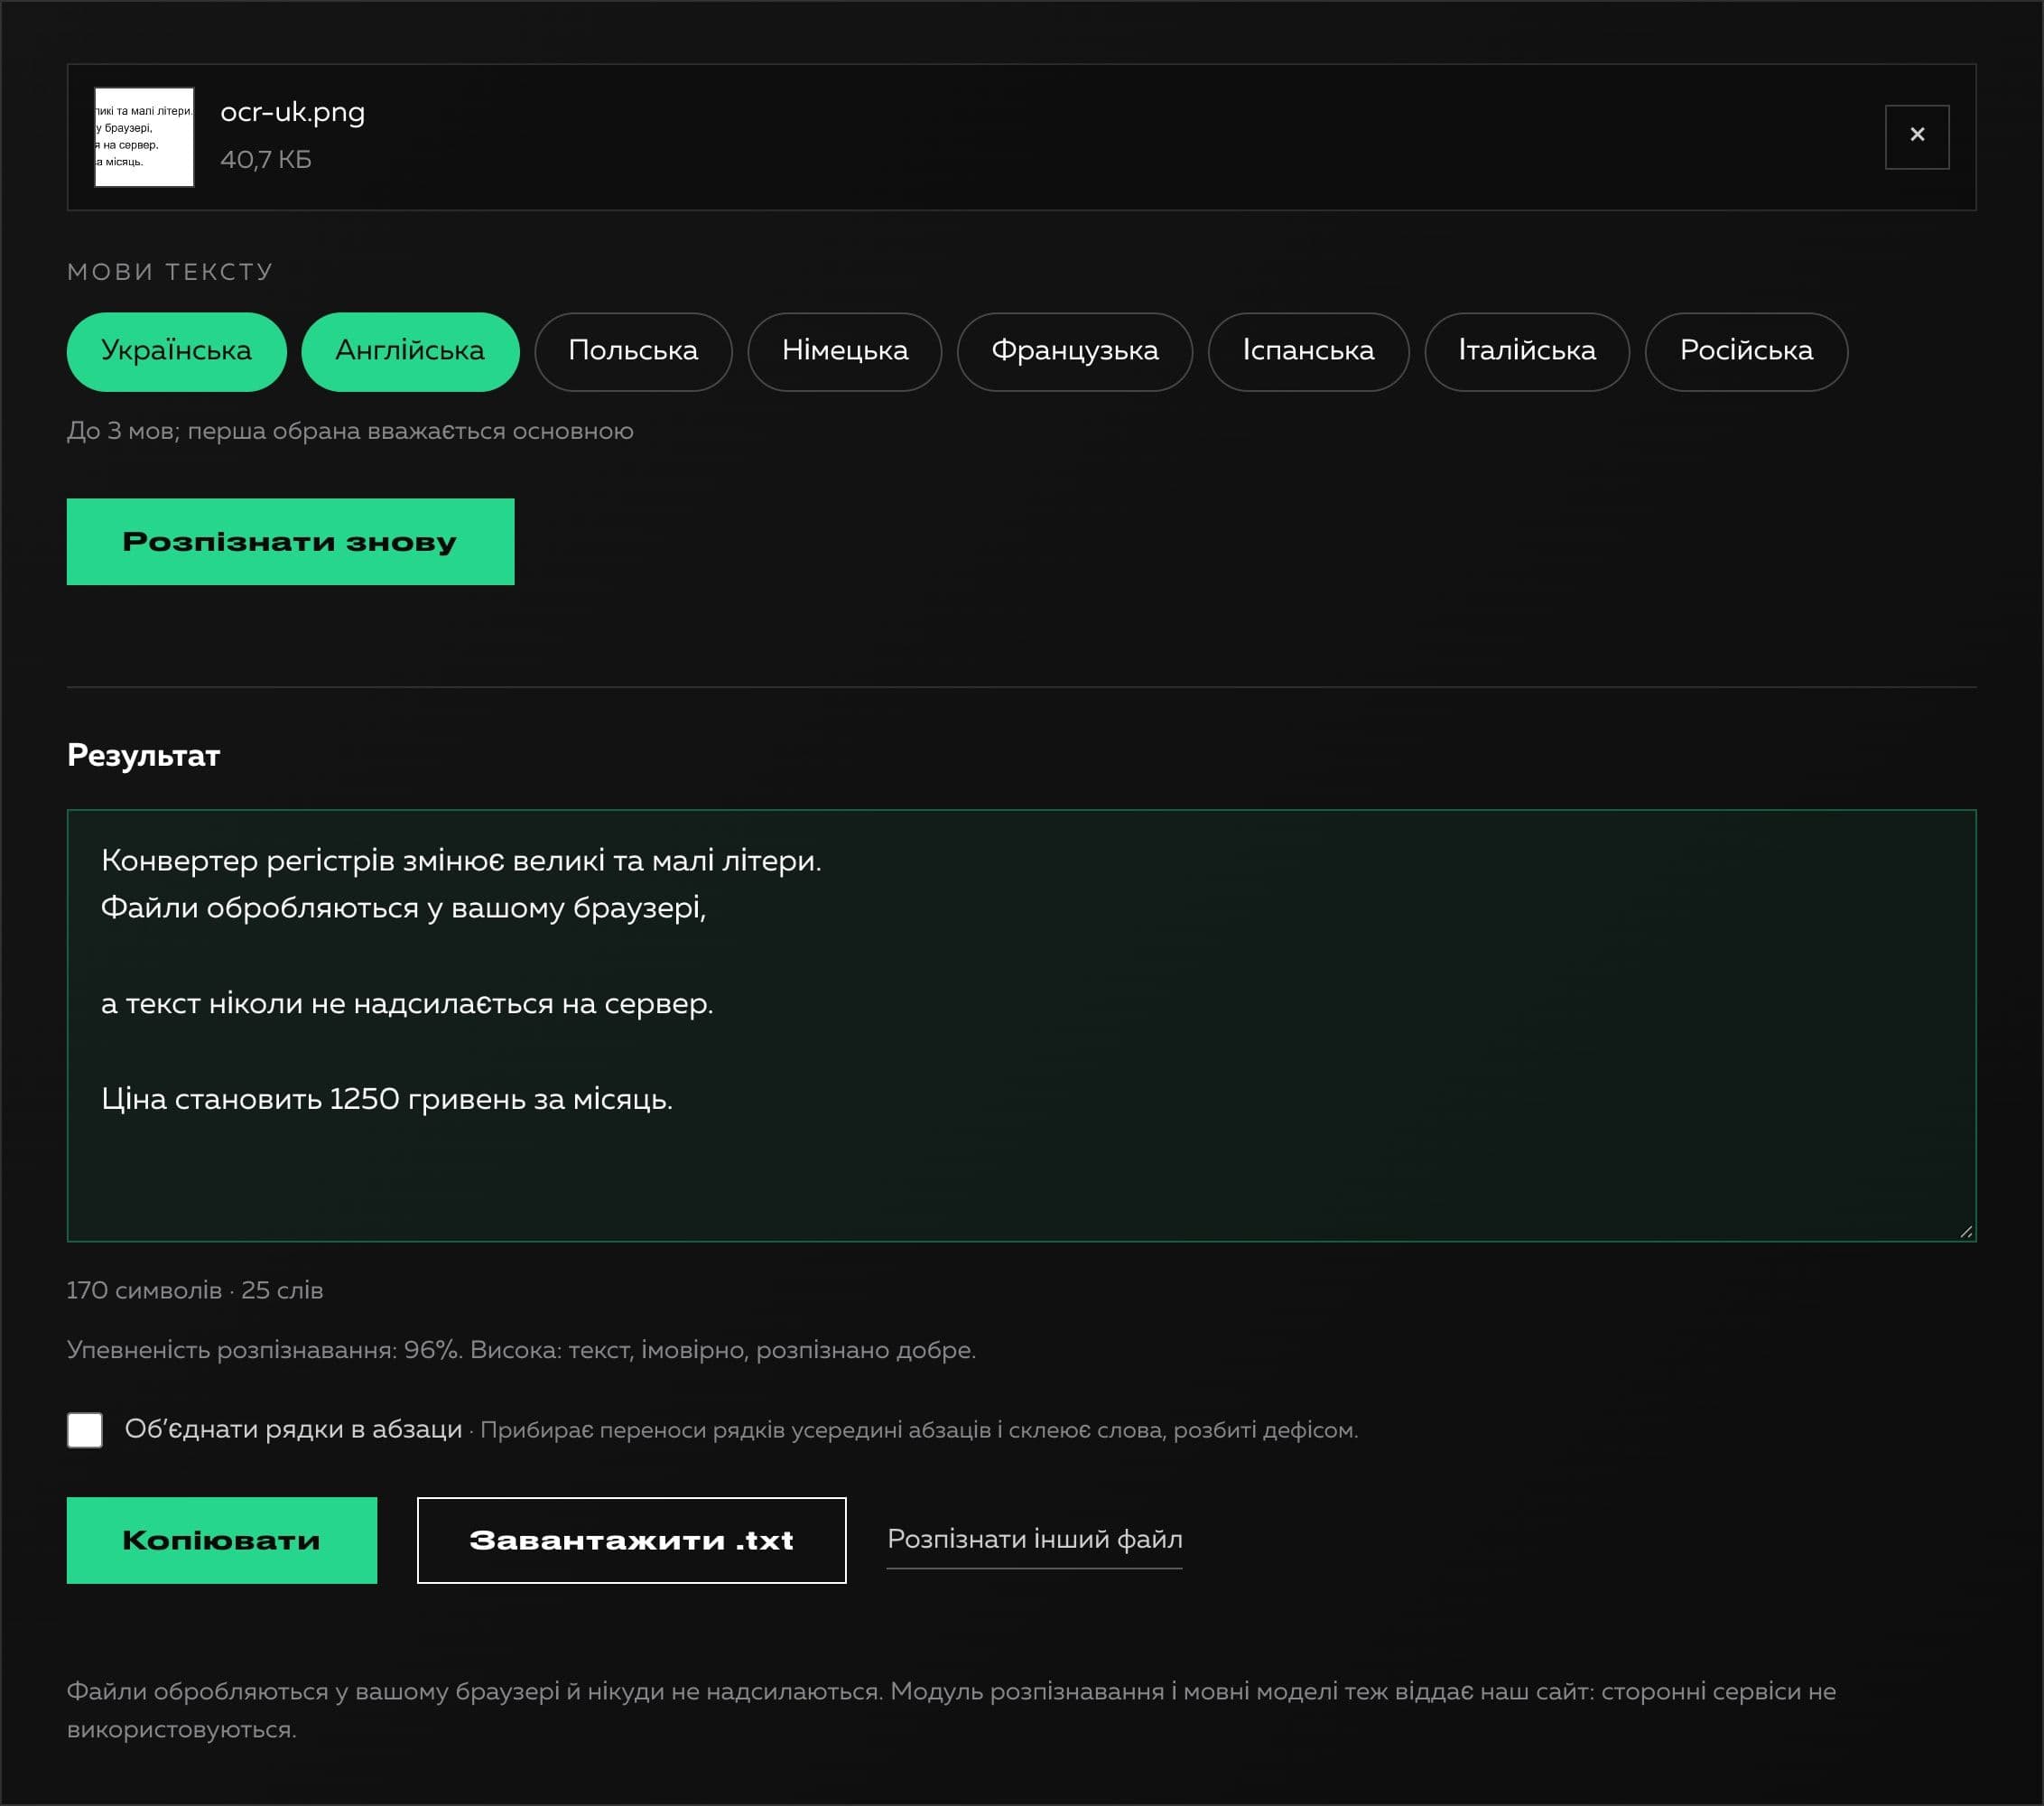
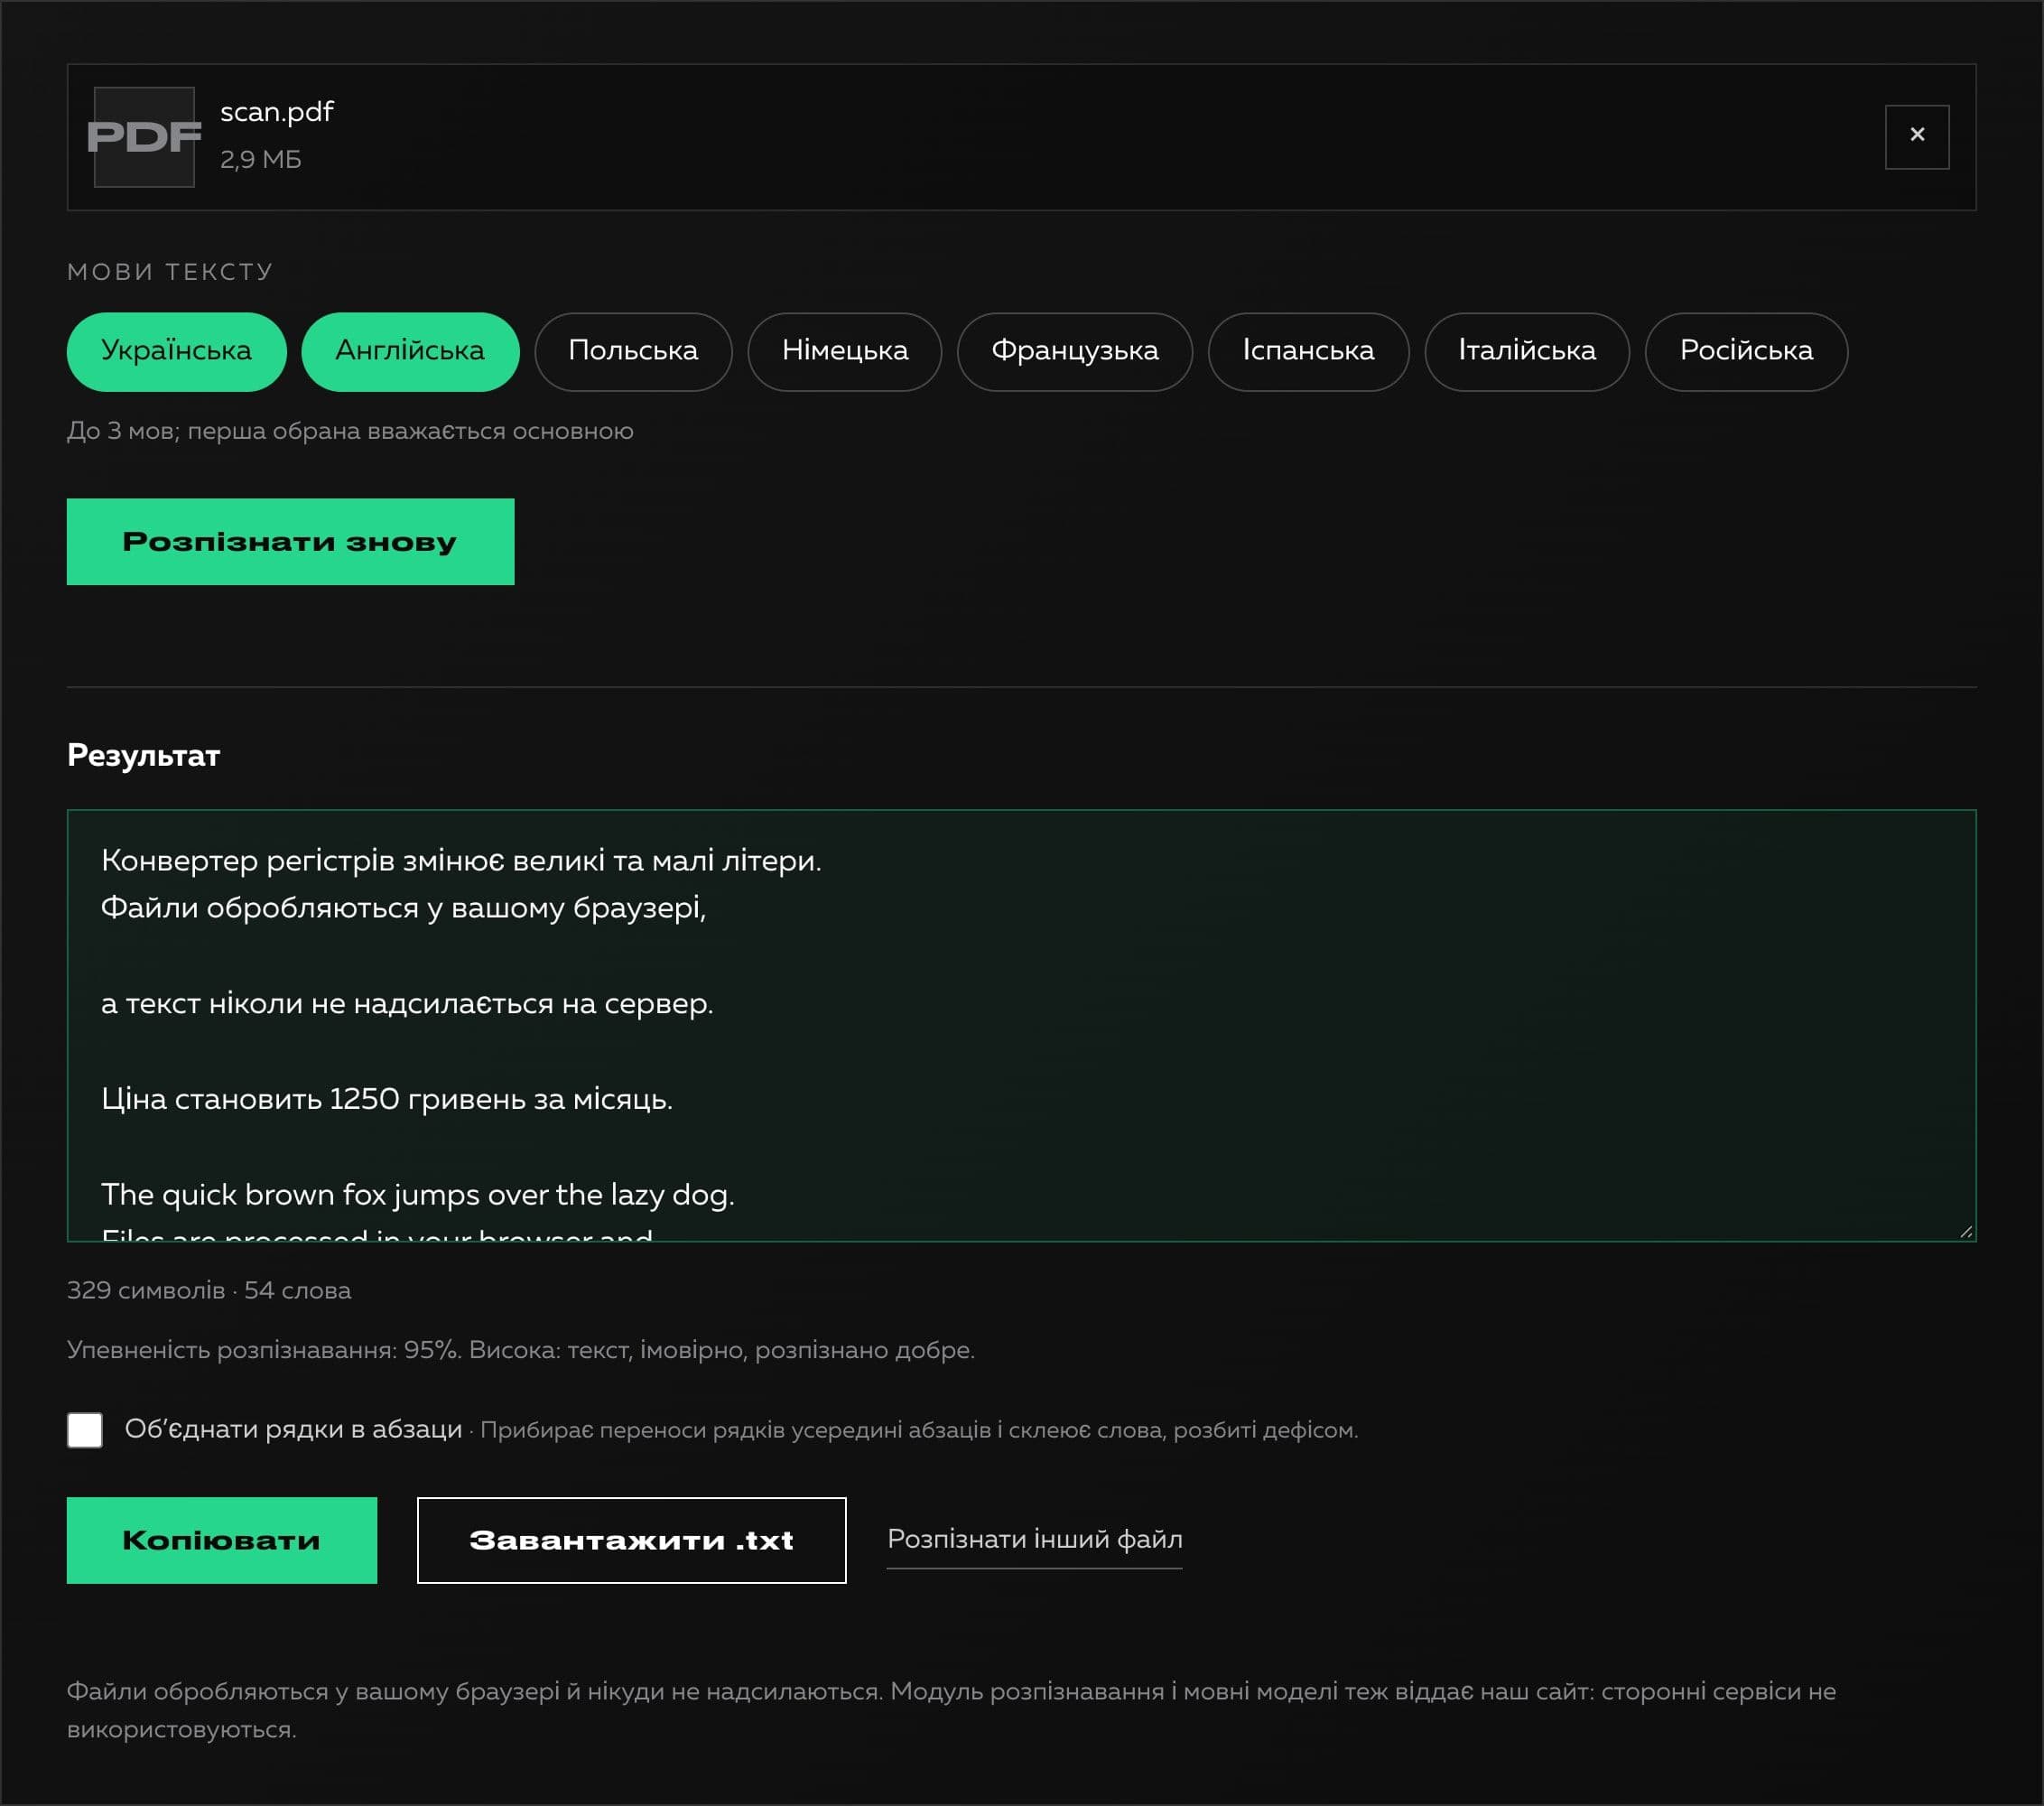
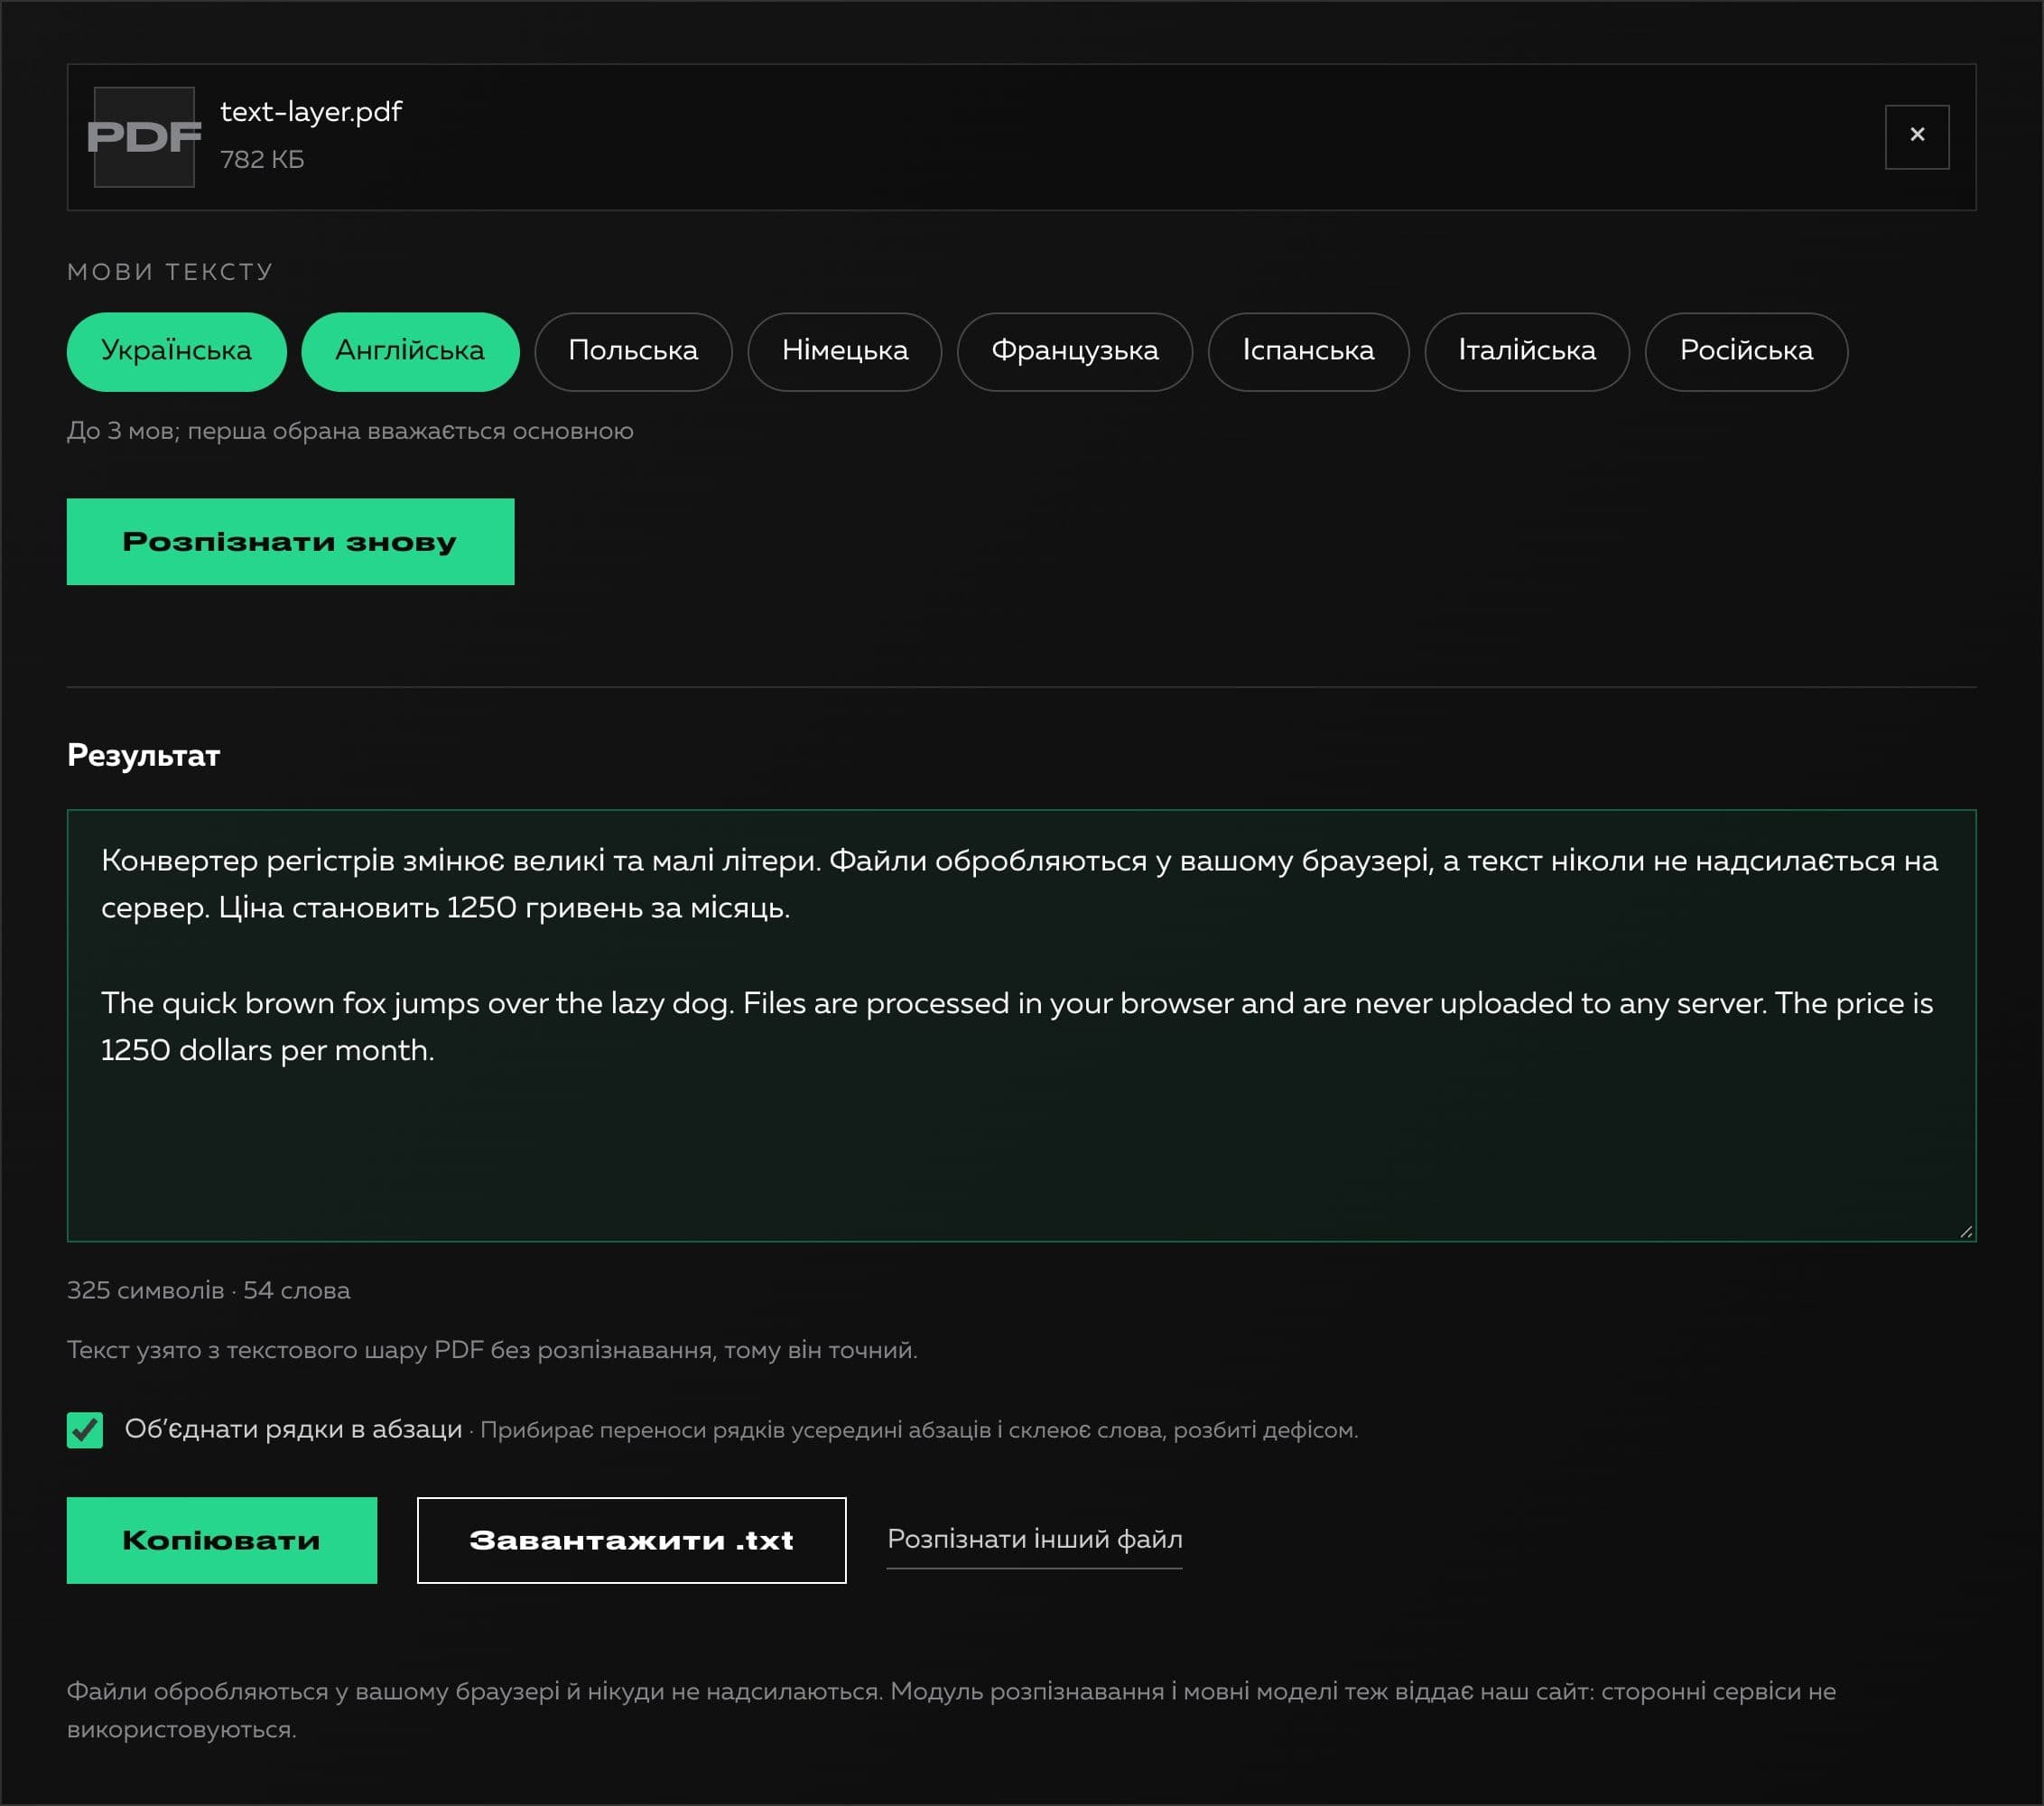
Ми розмістили рушій, воркер, ядро та моделі на нашому сайті (вісім мов: українська, англійська, польська, німецька, французька, іспанська, італійська й російська) і додали підтримку PDF через PDF.js: сторінки з текстовим шаром беруться точно й без розпізнавання, а скани розпізнаються сторінка за сторінкою (до 10 сторінок). Замість введення посилання з’явилась вставка скриншота через Ctrl+V. Додано справжній прогрес із назвою етапу й відсотками, скасування, яке не зависає, оцінку впевненості з порадою, лічильники та об’єднання рядків в абзаци з склейкою слів, розбитих дефісом. Для зображень діють ліміти (до 25 МБ і до 64 мегапікселів), а перед розпізнаванням картинка приводиться до розміру, зручного рушію.
Інтерфейс повністю переробили під дизайн сайту Creomatix, а наскрізні тести в Chrome перевіряють роботу на реальних файлах: на тестових зображеннях із друкованим текстом збіг із еталоном становив 90–100 %, обидва типи PDF розпізнаються, скасування та ліміти працюють, а жоден запит не виходить за межі нашого сайту.
Технології
- Next.js
- React
- TypeScript
- SCSS Modules
- Tesseract (tesseract.js) і моделі tessdata
- PDF.js
- Власний хостинг ядра, воркера й мов
- Strapi (контент сторінки продукту)
Який функціонал створили?
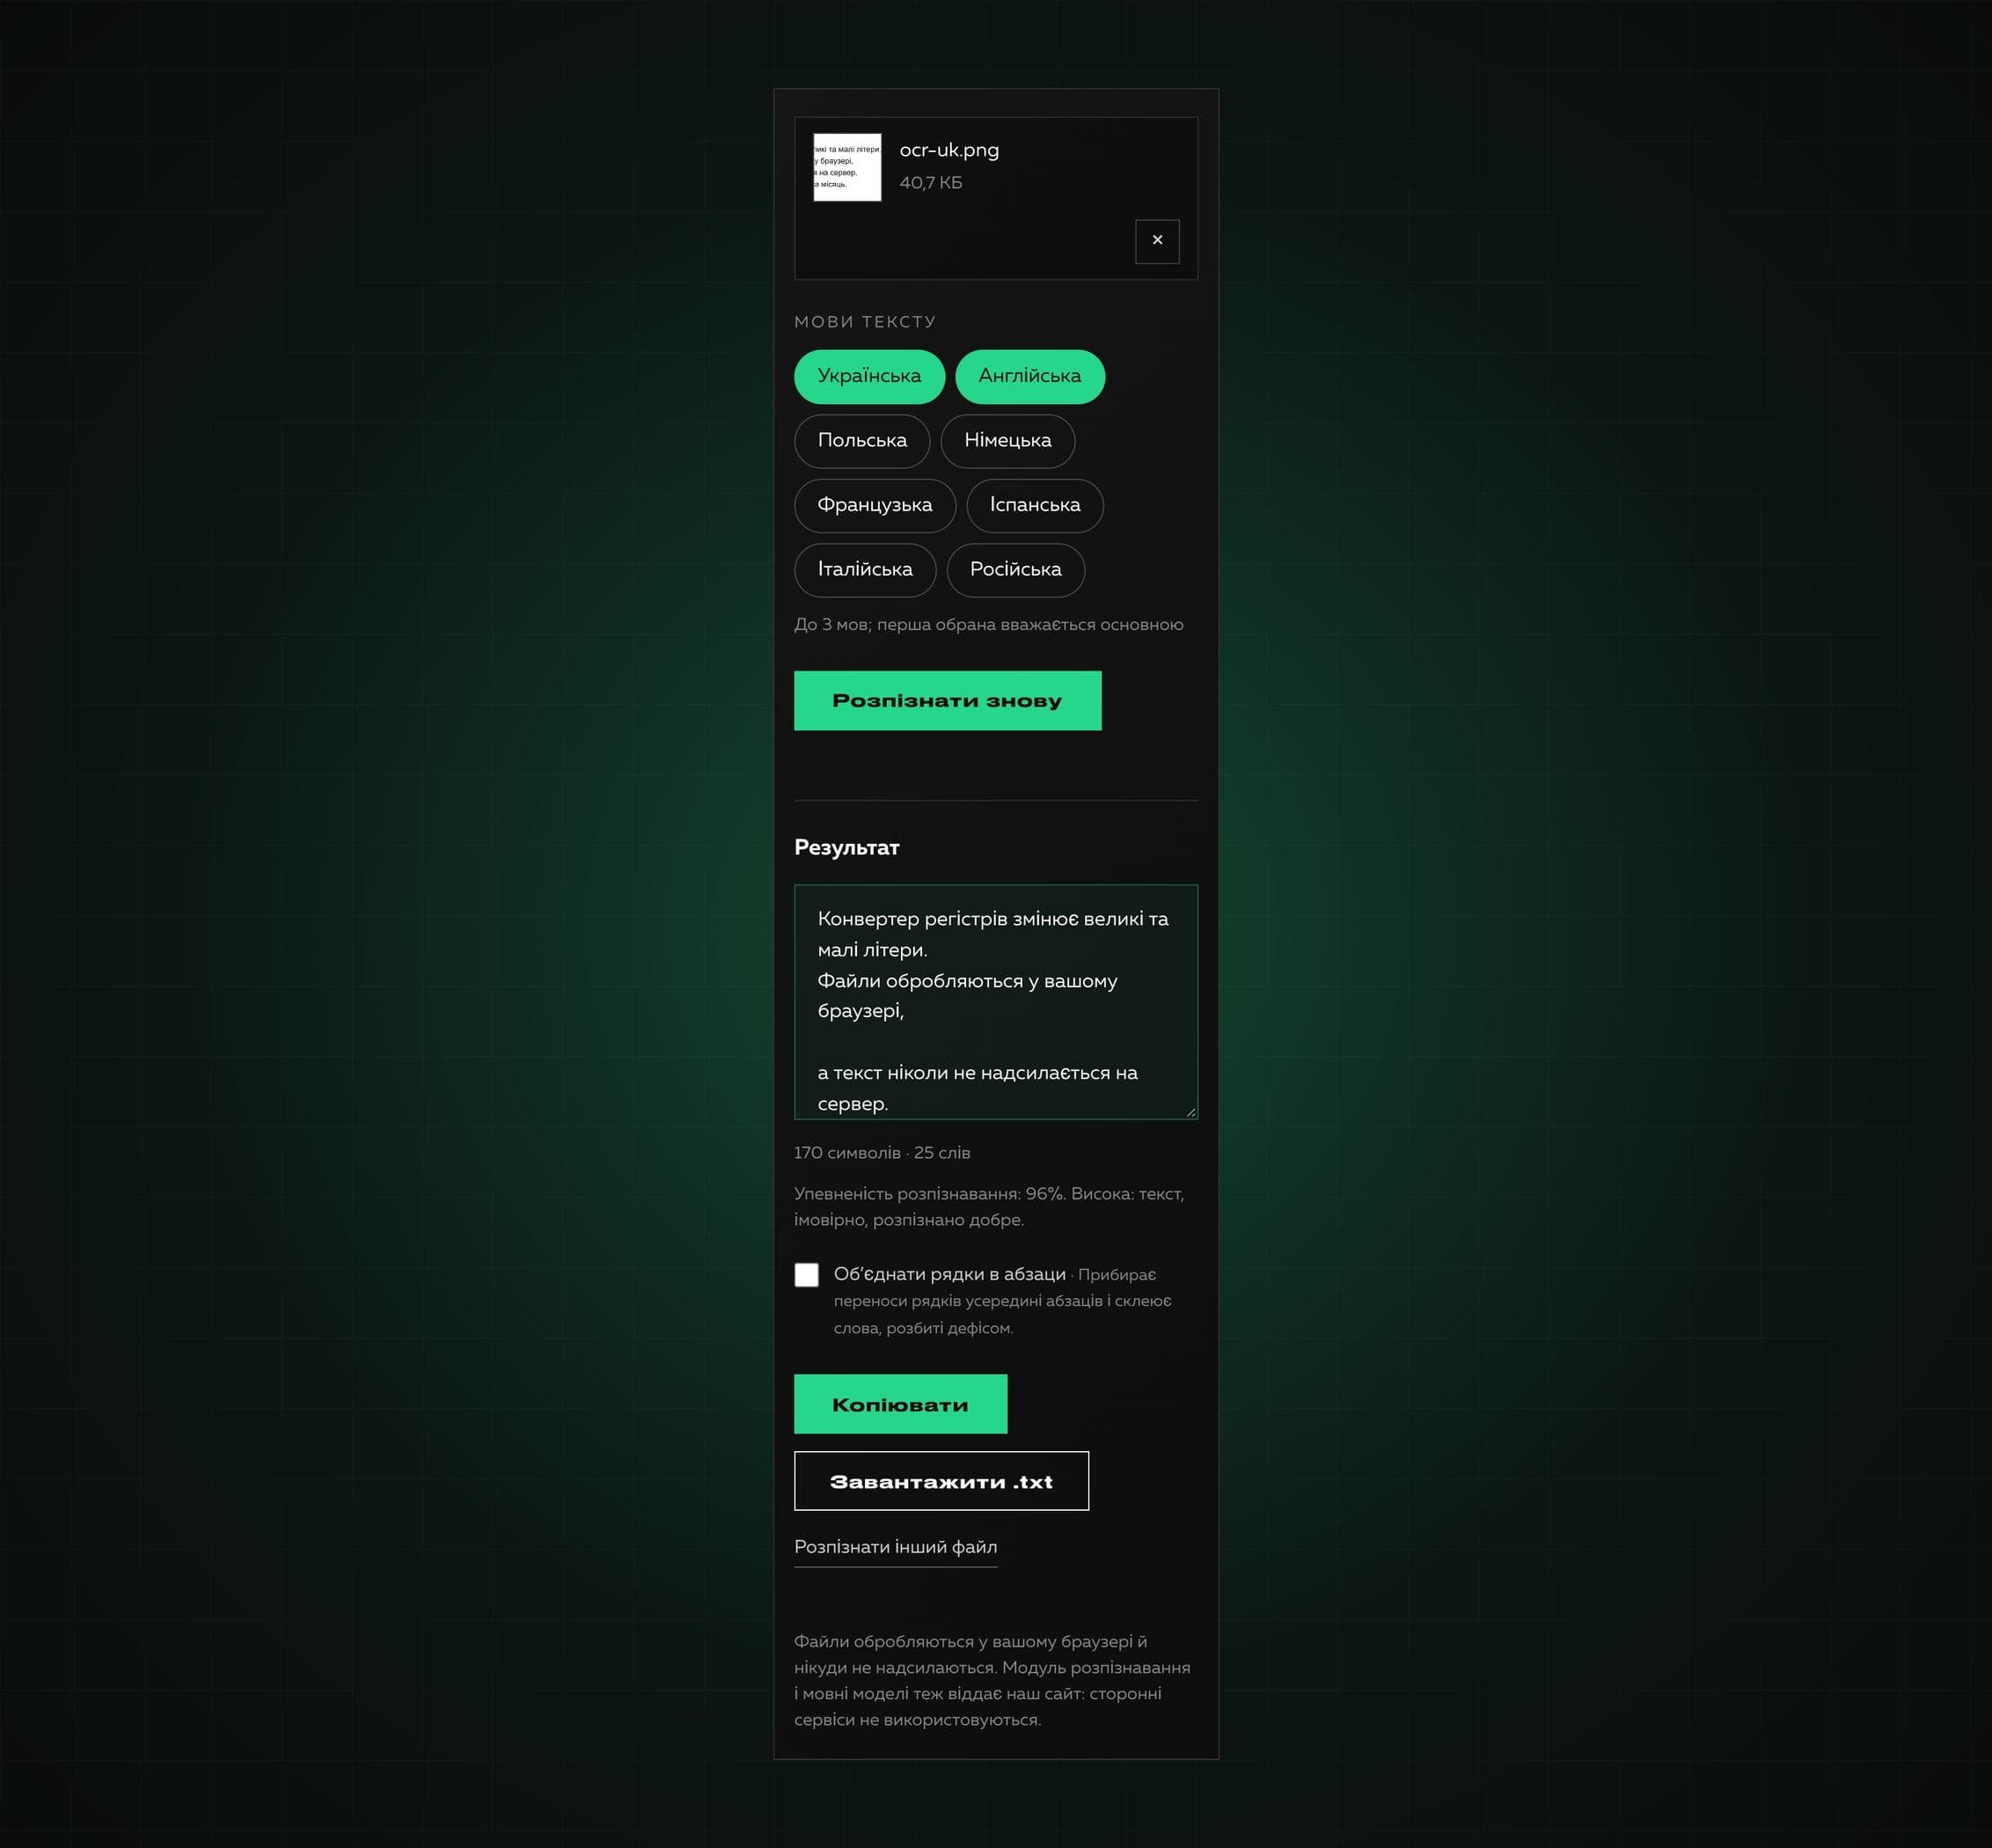
- Розпізнавання з фото, скриншотів (Ctrl+V) і PDF
- Вісім мов, до трьох одночасно
- PDF: текстовий шар беремо без розпізнавання, скани розпізнаємо сторінка за сторінкою (до 10 сторінок)
- Рушій, воркер і мовні моделі віддає наш сайт: жодних сторонніх CDN
- Справжній прогрес з етапом і відсотками та скасування
- Оцінка впевненості розпізнавання з порадою
- Лічильники, копіювання, завантаження .txt та об’єднання рядків в абзаци
- Ліміти: 25 МБ на файл, 64 МП на зображення
- Прозорі зображення розпізнаються на білому тлі
- Обробка повністю у браузері: файли не надсилаються
- Версії інтерфейсу українською та англійською
Що отримав клієнт?
У результаті з’явився зрозумілий і приватний інструмент: розпізнавання виконується у браузері, а сторонні сервіси не використовуються взагалі. Він працює із зображеннями та PDF, чесно показує прогрес і якість результату та став четвертим продуктом у розділі «Продукти» нашого сайту.