Робота з текстом · Безкоштовно
Розпізнавання тексту з фото (OCR)
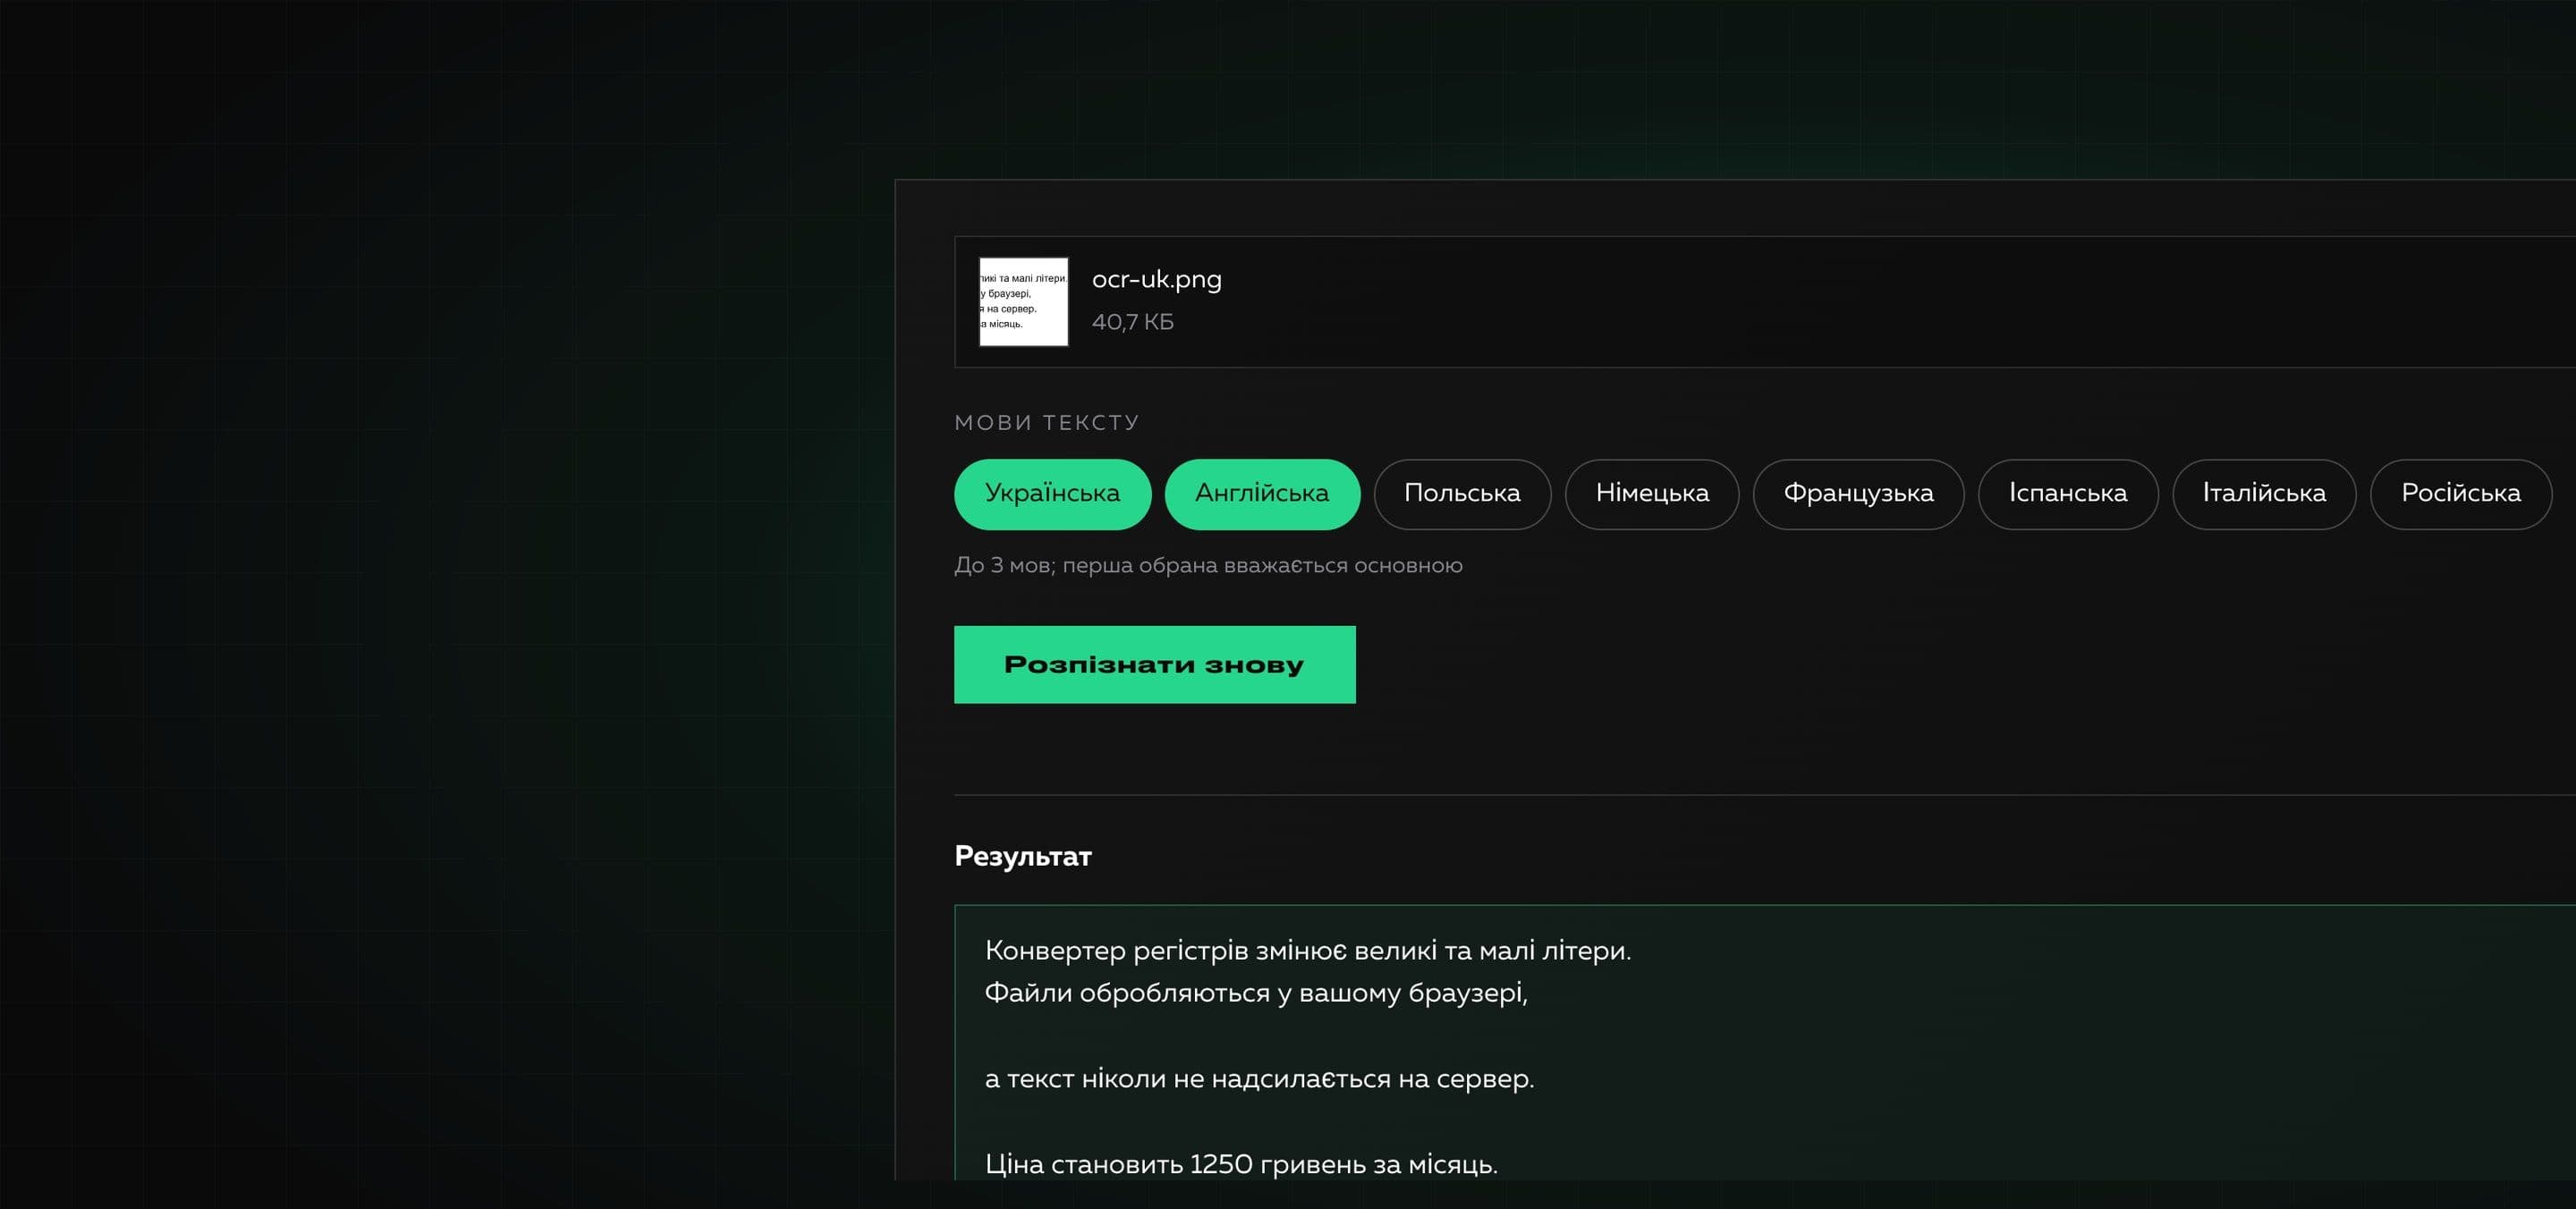
Безкоштовний онлайн-інструмент для розпізнавання тексту з зображень і PDF. Додайте файл або вставте скриншот, оберіть мови й отримайте текст, який можна скопіювати чи завантажити. Усе відбувається у вашому браузері.
Файли обробляються у вашому браузері й нікуди не надсилаються. Модуль розпізнавання і мовні моделі теж віддає наш сайт: сторонні сервіси не використовуються.
Текст на фото, у скріншоті чи скані документа не можна виділити й скопіювати. Розпізнавання тексту (OCR) перетворює такі зображення на звичайний текст, який можна редагувати, шукати й перекладати.
Інструмент працює на відкритому рушії Tesseract прямо у вашому браузері. Файли нікуди не надсилаються, а сам рушій і мовні моделі віддає наш сайт, тож сторонні сервіси не задіяні. Для PDF інструмент спершу перевіряє текстовий шар: якщо він є, текст береться точно й без розпізнавання, а скани розпізнаються сторінка за сторінкою.
Чим це корисно
- 01
Файли не залишають браузер
Розпізнавання виконується на вашому пристрої. Ні файли, ні мовні моделі не завантажуються зі сторонніх сервісів: усе віддає наш сайт.
- 02
Українська та ще 7 мов
Українська, англійська, польська, німецька, французька, іспанська, італійська й російська. Можна обрати до трьох мов одночасно для змішаних текстів.
- 03
Зображення й PDF
Фото, скриншоти (навіть через Ctrl+V) і PDF. Якщо в PDF є текстовий шар, текст береться точно, скани розпізнаються сторінка за сторінкою.
- 04
Чесний прогрес і оцінка якості
Видно етап і відсотки, розпізнавання можна скасувати, а після нього показується впевненість із порадою, чи варто перевіряти текст.
- 05
Зручний результат
Копіювання, завантаження у .txt і об’єднання рядків в абзаци: прибираються переноси та слова, розбиті дефісом.
Як користуватись
- 01
Додайте файл
Оберіть зображення чи PDF, перетягніть його в поле або вставте скриншот через Ctrl+V.
- 02
Оберіть мови
Позначте мови тексту (до трьох). Для українських документів з англійськими словами оберіть обидві.
- 03
Розпізнайте й заберіть текст
Натисніть «Розпізнати текст», а потім скопіюйте результат або завантажте його файлом .txt.
Де це стане в пригоді
Скриншот чи фото документа
Витягніть текст зі знімка екрана, фото сторінки чи презентації замість переписування вручну.
Скан договору чи PDF без тексту
Отримайте текст зі скану, щоб відредагувати його, знайти потрібне місце чи вставити в інший документ.
Цитати з книг і статей
Сфотографуйте абзац і скопіюйте його текст у нотатки чи реферат.
Тексти для перекладу
Дістаньте напис із зображення чи інтерфейсу, щоб відправити його в перекладач.
Чеки, візитки та таблички
Швидко перенесіть дані в таблицю. Числа й імена завжди перевіряйте вручну.
Як ми це створювали
Читайте в блозі
Часті запитання
Інструмент безкоштовний?
Так. Ним можна користуватись без оплати й без реєстрації.
Чи надсилаються мої файли на сервер?
Ні. Розпізнавання виконується у вашому браузері. Рушій і мовні моделі завантажуються з нашого сайту, а не зі сторонніх сервісів, тож ваші файли ніде не з’являються.
Чому перше розпізнавання довше?
Під час першого запуску браузер завантажує модуль розпізнавання й мовні моделі (кілька мегабайтів). Далі вони кешуються, і наступні запуски стартують швидше.
Як підвищити точність розпізнавання?
Використовуйте чітке зображення з рівним текстом і хорошим контрастом, без нахилу й відблисків. Дрібний шрифт краще збільшити. Обов’язково оберіть правильні мови: помилка з мовою сильно псує результат.
Чи розпізнає інструмент рукописний текст?
Ні. Він розрахований на друкований текст. Рукописний текст розпізнається погано.
Які є ліміти?
Файл до 25 МБ, зображення до 64 мегапікселів, у PDF обробляються перші 10 сторінок. Обмеження захищають вкладку від зависання, бо обробка йде на вашому пристрої.
Що буде з PDF, у якому вже є текст?
Для таких сторінок текст береться з текстового шару без розпізнавання: це швидше й точніше. Сторінки-картинки розпізнаються як звичайні зображення.
Потрібен власний інструмент для вашої команди?
Ми створюємо корисні онлайн-інструменти й внутрішні сервіси: від ідеї та дизайну до запуску. Розкажіть, яку рутину варто прибрати.